Как читать этот разбор. Работа короткая, главное в ней одна формула: дефлированный Шарп. Без формул вывод такой: прежде чем радоваться Шарпу лучшего варианта, сравни его не с нулём, а с тем Шарпом, который выдал бы лучший из вариантов при полном отсутствии навыка. Это раздел «Метод в одну строку». Наша проверка в разделе 5, практические выводы в разделе 6.
Главный тезис
Самая важная информация, которой нет почти ни в одном опубликованном бэктесте, это число испытаний. Если перепробовать вариантов стратегии, лучший из них будет иметь высокий Шарп даже при полном отсутствии навыка, и чем больше , тем выше. Авторы выводят, каким будет ожидаемый максимум Шарпа среди испытаний без навыка, и используют его как порог: значим только тот Шарп, который уверенно превышает этот максимум, с учётом длины ряда, асимметрии и толстых хвостов.
В отличие от PBO (Bailey, Borwein, López de Prado, Zhu), метод параметрический и требует мало данных: число независимых испытаний, разброс их Шарпов, длину ряда, асимметрию и эксцесс выбранной стратегии.
1. Откуда берётся завышение
Авторы различают три близких явления. Множественное тестирование: если проверить много стратегий на одних данных, каждую на уровне 5 %, вероятность хоть одной ложной находки растёт. Смещение отбора: публикуются только прошедшие проверку, остальные прячутся («file drawer», survivorship, backfilling). Переподгонка бэктеста: параметры подогнаны под случайный рисунок прошлого. Авторы добавляют довод про «память» рынка: если рынок возвращает отклонения к равновесию, правило, подогнанное под самые сильные случайные отклонения, вне выборки систематически теряет.
Отложенная выборка, по их словам, не спасает: она проверяет модель так, будто испытание было одно. "If we apply the holdout method enough times (say 20 times for a 95% confidence level), false positives are no longer unlikely: They are expected."
2. Метод в одну строку
Ожидаемый максимум Шарпа среди независимых испытаний без навыка:
Что это такое. Сколько в среднем покажет лучший из вариантов, если навыка нет и Шарпы вариантов разбросаны случайно вокруг среднего.
Что означает каждый значок. : оценённый Шарп -го испытания. , : среднее и дисперсия Шарпов по всем испытаниям, то есть разброс между ними. (гамма): постоянная Эйлера–Маскерони, около 0.5772. : квантиль стандартного нормального распределения, число, ниже которого лежит доля значений. : основание натурального логарифма.
Счёт по шагам. 1) Посчитай . 2) Посчитай . 3) Сложи их с весами 0.4228 и 0.5772. 4) Умножь на корень из дисперсии Шарпов и прибавь средний Шарп.
Пример, наш счёт. При : , , взвешенная сумма 2.531. То есть лучший из ста бесполезных вариантов в среднем выше среднего на 2.53 стандартных отклонения разброса Шарпов. При уже 3.26.
Зачем это нужно. Это и есть порог, который Шарп лучшего варианта должен превзойти, чтобы что-то значить.
Дефлированный Шарп это вероятностный Шарп (PSR), посчитанный против этого порога:
Что это такое. Вероятность того, что настоящий Шарп выбранной стратегии выше порога , то есть выше того, что дал бы случайный лучший вариант.
Что означает каждый значок. : Шарп выбранной стратегии за один период (не годовой). : порог из формулы выше при среднем Шарпе испытаний . : число наблюдений. (гамма три): асимметрия доходностей; отрицательная значит редкие крупные убытки. (гамма четыре): эксцесс, не избыточный: у нормального распределения он равен 3. : функция стандартного нормального распределения.
Счёт по шагам на числах работы. Стратег перебрал независимых вариантов сезонной стратегии на казначейских облигациях; лучший даёт годовой Шарп 2.5 на пяти годах дневных данных (); дисперсия годовых Шарпов по вариантам ; асимметрия −3, эксцесс 10.
- Перевести в дневные единицы: , дисперсия .
- Порог: в день, или 1.79 годовых.
- Числитель: .
- Знаменатель: .
- .
В работе 0.9004 и вывод: инвестор отказывает, порог 95 % не пройден.
Зачем это нужно. Обычный Шарп учитывает два числа (среднее и разброс доходностей). DSR учитывает ещё пять: асимметрию, эксцесс, длину ряда, разброс Шарпов по испытаниям и число независимых испытаний.
3. Что ещё в работе
Чувствительность к числу испытаний. Тот же Шарп 2.5 прошёл бы порог 95 %, если бы стратег перебрал не больше 46 вариантов (DSR 0.9505). При нормальных доходностях (асимметрия 0, эксцесс 3) допустимо до 88 вариантов. Толстые хвосты и отрицательная асимметрия почти вдвое сокращают «бюджет испытаний».
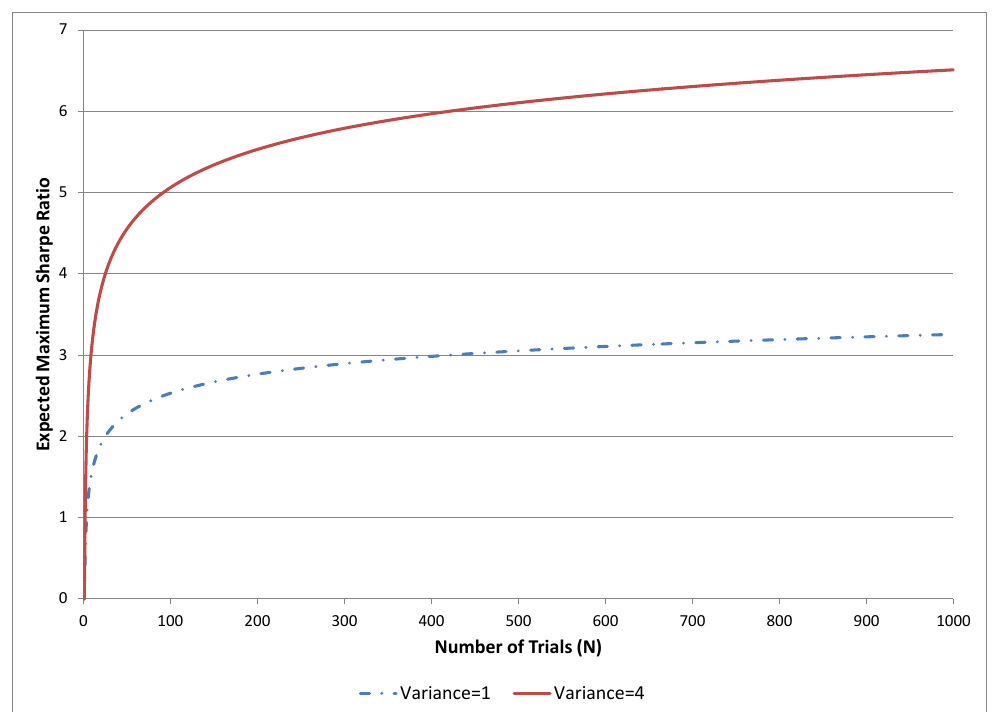
Как его читать. По горизонтали число независимых испытаний до 1 000, по вертикали ожидаемый максимум Шарпа при среднем 0. Синяя пунктирная линия при дисперсии Шарпов 1, красная при дисперсии 4.
Что нужно увидеть. Кривая растёт быстро до сотни испытаний и потом медленно: к 1 000 испытаний около 3.3 при дисперсии 1 и около 6.5 при дисперсии 4.
Практический вывод. Разброс Шарпов между вариантами важен не меньше их числа: вдвое большее стандартное отклонение Шарпов (дисперсия 4 вместо 1) вдвое поднимает порог.
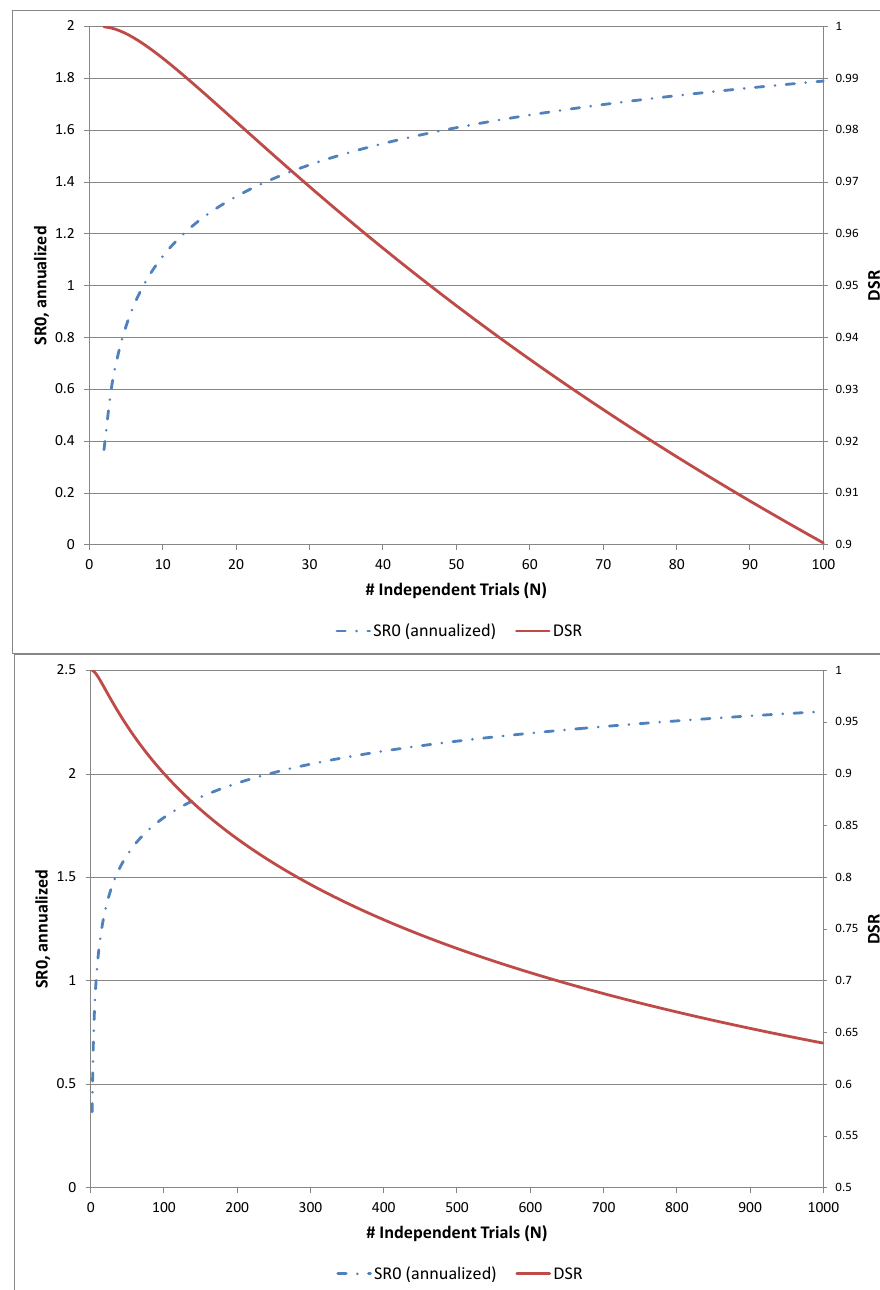
Как его читать. Две панели для одного примера: до 100 и до 1 000 испытаний. Синий пунктир это порог в годовом выражении (левая шкала), красная линия DSR (правая шкала).
Что нужно увидеть. На верхней панели DSR падает ниже 0.95 около 46 испытаний и доходит до 0.90 к сотне. На нижней к тысяче испытаний DSR около 0.64 (наш расчёт по формуле 0.640).
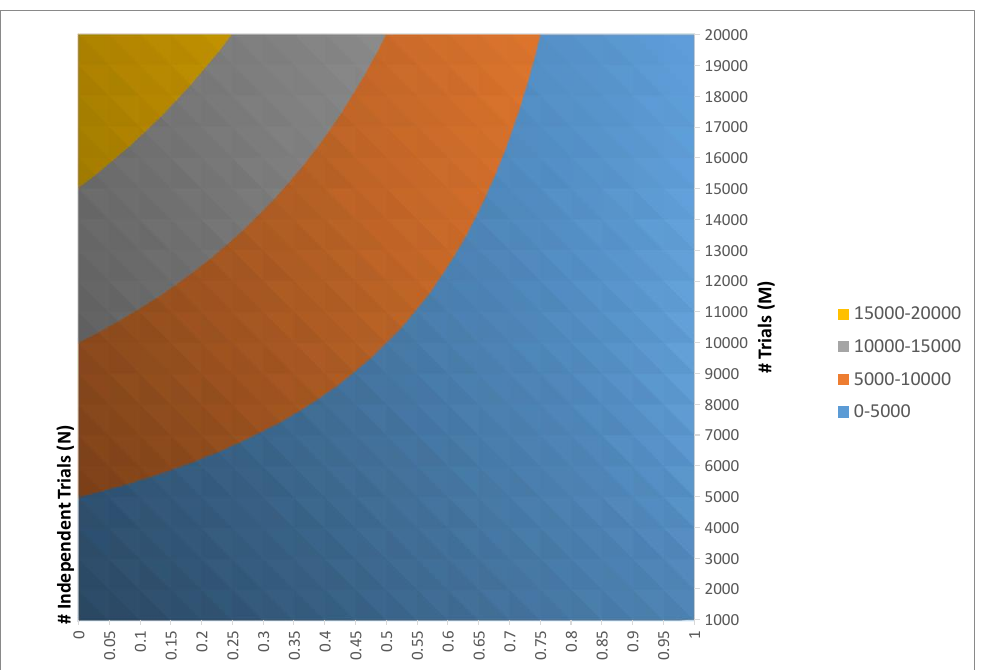
Число независимых испытаний. Если испытания коррелированы, меньше, чем фактически прогнано (). Авторы предлагают через среднюю корреляцию интерполяцию
Что это такое. При корреляции 0 все испытаний независимы, при корреляции 1 испытание фактически одно; между ними линейно.
Пример, наш счёт. , : .
и сами отмечают её слабости: корреляция ловит только линейную зависимость, а при числе испытаний больше длины ряда матрица корреляций плохо обусловлена, и оценка средней корреляции сама переподогнана. Как альтернативу они упоминают методы теории информации.
Когда остановиться. Авторы предлагают правило оптимальной остановки («задача о секретаре», закон ): из теоретически обоснованных конфигураций случайно выбрать и проверить около 37 %, затем проверять по одной и остановиться на первой, которая лучше всех предыдущих. Это эвристика из другой задачи, сами авторы в сноске оговаривают, что в выборе стратегии, в отличие от исходной задачи, к прошлому кандидату вернуться можно.
4. Проверка формулы максимума в работе
Авторы сравнивают приближение с симуляцией на сетке «среднее × число испытаний» по 10 000 повторов (приложение A.2, Exhibit 3.1 и 3.2).
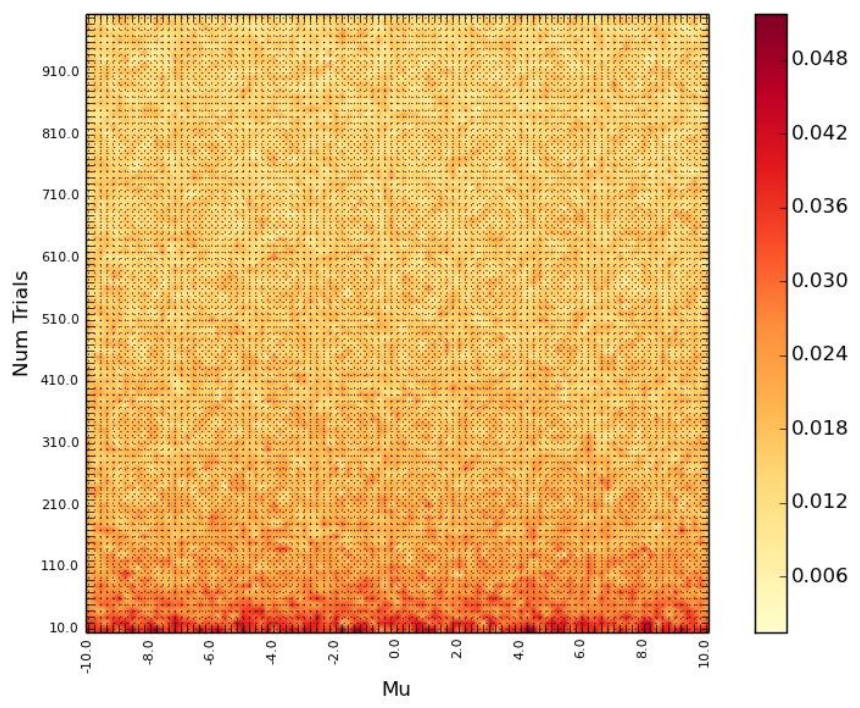
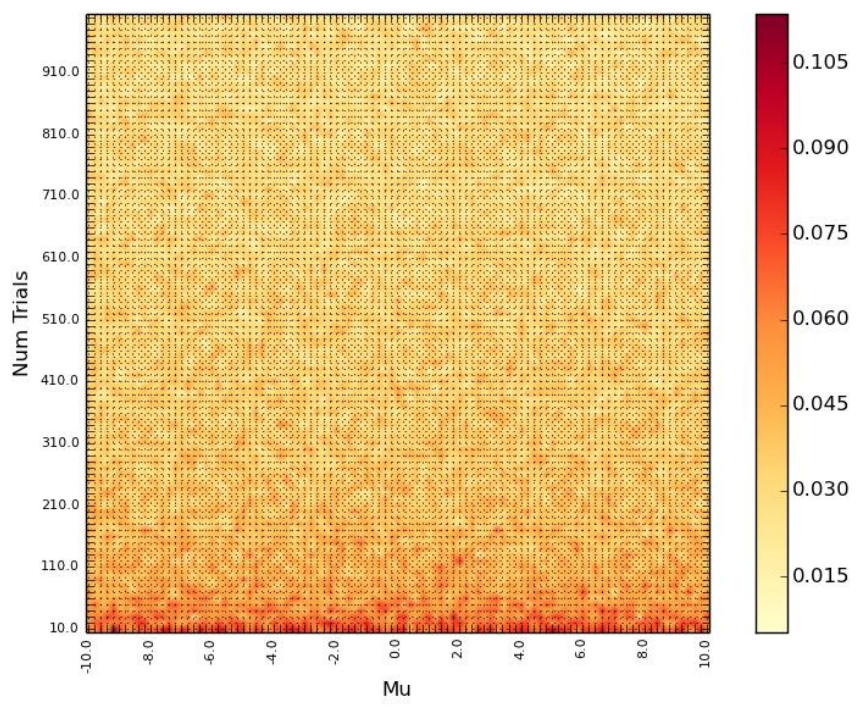
Как читать. По горизонтали среднее Шарпов (Mu), по вертикали число испытаний от 10 до 1 000, цвет это ошибка «приближение минус симуляция». Внизу, при малом числе испытаний, ошибка до 0.05 (дисперсия 1) и до 0.11 (дисперсия 4); выше цвет ровный, около 0.012–0.018.
Что нужно увидеть. Ошибка не зависит от среднего (полосы горизонтальные) и всегда положительна: приближение немного завышает максимум, то есть порог чуть строже, чем нужно.
5. Что в работе шатко
Что нашлось при сверке
Численный пример воспроизводится до четвёртого знака. , DSR 0.9004, при DSR 0.9505, при нормальных доходностях и тоже 0.9505; это последние , при которых DSR не ниже 0.95.
Код и рисунок не совпадают по диапазону. В Snippet 1 среднее перебирается как np.linspace(-100,100,101), то есть от −100 до 100, а на тепловых картах Exhibit 3.1 и 3.2 ось Mu идёт от −10 до 10. Рисунок построен не тем кодом, который приложен, или код правился после. На вывод не влияет: ошибка от среднего не зависит.
В число расхождений работы (поле на сайте) идёт только это: несовпадение работы с самой собой. Всё ниже наша проверка, а не противоречие внутри текста.
Наша проверка, которой в работе нет
Точность приближения хуже, чем написано. Авторы: "by 1000 trials it is as small as 0.006 for a process with variance 1" и "The error quickly converges to zero as the number of trials grows". Мы посчитали точное ожидание максимума численным интегрированием: ошибка приближения +0.036 при 10 испытаниях, +0.023 при 100, +0.014 при 1 000. Она убывает медленно. Цифра 0.006, по всей видимости, минимум по ячейкам тепловой карты, где каждая ячейка зашумлена симуляцией (стандартная ошибка около 0.004), а типичный цвет карты на больших как раз 0.012–0.018. Ошибка в безопасную сторону, порог чуть завышен.
Формула (9) учитывает корреляцию дважды, если дисперсия Шарпов взята как разброс между испытаниями. Работа определяет как "the variance across the trials’ estimated SR", то есть разброс Шарпов между вариантами. При коррелированных испытаниях этот разброс уже меньше настоящей дисперсии каждого Шарпа: общая часть шума у всех одинакова и в разброс не попадает. Если после этого ещё и уменьшить число испытаний по (9), корреляция учтена дважды, порог занижен и DSR выходит мягче, чем должен.
Наш опыт на модели с одинаковой корреляцией между всеми испытаниями, 1 000 испытаний без навыка, 4 000 повторов:
| Корреляция | Фактический средний максимум | при | То же при по (9) |
|---|---|---|---|
| 0.0 | 3.237 | 3.256 | 3.256 |
| 0.3 | 2.715 | 2.722 | 2.636 () |
| 0.5 | 2.280 | 2.301 | 2.158 () |
| 0.8 | 1.435 | 1.455 | 1.237 () |
Все числа в единицах стандартного отклонения Шарпа одного испытания. В этой модели верный ответ даёт при разбросе между испытаниями; поправка (9) занижает порог относительно него на 0.09, 0.14 и 0.22 при корреляции 0.3, 0.5 и 0.8. Если же дисперсию брать не по разбросу между испытаниями, а как теоретическую дисперсию одного Шарпа, то эффективное должно быть намного меньше, чем даёт (9). Линейная интерполяция (9) не следует ни из того, ни из другого; авторы так и пишут, что это интерполяция между крайними случаями. Наш вывод, модель с одинаковой корреляцией наша.
Мелочи
Подпись Exhibit 3.2 ссылается на "Exhibit 2.1", хотя имеется в виду 3.1. Заголовок приложения A.1: "EXPECTED MAXIMUM SHARE RATIO". В тексте Американская статистическая ассоциация названа «Society» и датирована 1997 годом, в списке литературы 1999.
Тонкость в формулировке. Авторы пишут, что инвестор понял: "there is only a 90% chance that the true SR associated with this strategy is greater than zero". Формально DSR это вероятность превысить порог ; читать её как «шанс, что настоящий Шарп больше нуля» можно только в логике работы, где порог и есть ноль, поправленный на отбор.
6. Что из этого практически следует
Хранить число испытаний и разброс их Шарпов. Без этих двух чисел DSR не посчитать. Оптимизатор, который сохраняет только победителя, делает проверку невозможной задним числом, как и для PBO.
Считать Шарп в единицах одного периода и брать полный эксцесс. Подставить в формулу годовой Шарп или избыточный эксцесс вместо полного значит получить бессмысленный результат.
Для коррелированного перебора параметров не уменьшать по (9), если это разброс Шарпов между вариантами. На нашей модели честнее брать равным числу прогонов.
Асимметрия решает. Стратегии с редкими крупными убытками (продажа волатильности, усреднение) получают гораздо меньший «бюджет испытаний», чем трендовые с положительной асимметрией.
DSR и PBO дополняют друг друга. DSR быстрый и требует пять чисел, но опирается на нормальность Шарпов по испытаниям. PBO непараметрический, но требует полной матрицы доходностей всех вариантов.
7. Тестируемые идеи
| № | Идея | Тип | Где считать |
|---|---|---|---|
| 1 | Считать DSR для каждого финалиста: порог по числу независимых испытаний и разбросу Шарпов всех испытаний, отсечка 0.95 | метрика приёмки | Python |
| 2 | Журнал перебора: число испытаний и Шарп каждого, чтобы потом посчитать разброс ; без него DSR не восстановить | аудит | любая |
| 3 | Не уменьшать по формуле (9), если взята как разброс Шарпов между испытаниями: корреляция учитывается дважды, DSR выходит мягче | аудит | Python |
| 4 | Подставлять Шарп за период, а не годовой, и полный эксцесс (у нормального 3); проверить на своих стратегиях, насколько асимметрия сокращает допустимое число испытаний (в примере с 88 до 46) | диагностика | Python |
| 5 | Быстрый порог «случайного лучшего»: ожидаемый максимум из стандартных нормальных (2.53 при 100, 3.26 при 1 000) умножить на разброс Шарпов перебора | диагностика | любая |
| 6 | Проверить правило остановки на своих переборах: сколько испытаний оно экономит и не теряет ли настоящий эффект | изменение конструкции | Python |
| 7 | Посчитать на одном переборе и DSR, и PBO, и разобрать случаи, где они расходятся | метрика приёмки | Python |