Як читати цей розбір. Робота коротка, головне в ній одна формула: дефльований Шарп. Без формул висновок такий: перш ніж радіти Шарпу найкращого варіанта, порівняй його не з нулем, а з тим Шарпом, який дав би найкращий із варіантів за повної відсутності майстерності. Це розділ «Метод в один рядок». Наша перевірка в розділі 5, практичні висновки в розділі 6.
Головна теза
Найважливіша інформація, якої немає майже в жодному опублікованому бектесті, це кількість випробувань. Якщо перепробувати варіантів стратегії, найкращий із них матиме високий Шарп навіть за повної відсутності майстерності, і що більше , то вищий. Автори виводять, яким буде очікуваний максимум Шарпа серед випробувань без майстерності, і використовують його як поріг: значущий лише той Шарп, який упевнено перевищує цей максимум, з урахуванням довжини ряду, асиметрії і товстих хвостів.
На відміну від PBO (Bailey, Borwein, López de Prado, Zhu), метод параметричний і потребує небагато даних: кількість незалежних випробувань, розкид їхніх Шарпів, довжину ряду, асиметрію та ексцес обраної стратегії.
1. Звідки береться завищення
Автори розрізняють три близькі явища. Множинне тестування: якщо перевірити багато стратегій на тих самих даних, кожну на рівні 5 %, імовірність хоч одного хибного відкриття зростає. Зміщення відбору: публікують лише ті, що пройшли перевірку, решту ховають («file drawer», survivorship, backfilling). Перепідгонка бектесту: параметри підігнано під випадковий малюнок минулого. Автори додають аргумент про «пам'ять» ринку: якщо ринок повертає відхилення до рівноваги, правило, підігнане під найсильніші випадкові відхилення, поза вибіркою систематично втрачає.
Відкладена вибірка, за їхніми словами, не рятує: вона перевіряє модель так, ніби випробування було одне. "If we apply the holdout method enough times (say 20 times for a 95% confidence level), false positives are no longer unlikely: They are expected."
2. Метод в один рядок
Очікуваний максимум Шарпа серед незалежних випробувань без майстерності:
Що це таке. Скільки в середньому покаже найкращий із варіантів, якщо майстерності немає і Шарпи варіантів розкидані випадково навколо середнього.
Що означає кожен значок. : оцінений Шарп -го випробування. , : середнє й дисперсія Шарпів за всіма випробуваннями, тобто розкид між ними. (гамма): стала Ейлера–Маскероні, близько 0.5772. : квантиль стандартного нормального розподілу, число, нижче від якого лежить частка значень. : основа натурального логарифма.
Рахунок за кроками. 1) Порахуй . 2) Порахуй . 3) Додай їх із вагами 0.4228 і 0.5772. 4) Помнож на корінь із дисперсії Шарпів і додай середній Шарп.
Приклад, наш розрахунок. За : , , зважена сума 2.531. Тобто найкращий із сотні марних варіантів у середньому вищий за середнє на 2.53 стандартного відхилення розкиду Шарпів. За уже 3.26.
Навіщо це потрібно. Це і є поріг, який Шарп найкращого варіанта має перевершити, щоб щось означати.
Дефльований Шарп це ймовірнісний Шарп (PSR), порахований проти цього порогу:
Що це таке. Імовірність того, що справжній Шарп обраної стратегії вищий за поріг , тобто вищий за те, що дав би випадковий найкращий варіант.
Що означає кожен значок. : Шарп обраної стратегії за один період (не річний). : поріг із формули вище за середнього Шарпа випробувань . : кількість спостережень. (гамма три): асиметрія дохідностей; від'ємна означає рідкісні великі збитки. (гамма чотири): ексцес, не надлишковий: у нормального розподілу він дорівнює 3. : функція стандартного нормального розподілу.
Рахунок за кроками на числах роботи. Стратег перебрав незалежних варіантів сезонної стратегії на казначейських облігаціях; найкращий дає річний Шарп 2.5 на п'яти роках денних даних (); дисперсія річних Шарпів за варіантами ; асиметрія −3, ексцес 10.
- Перевести в денні одиниці: , дисперсія .
- Поріг: на день, або 1.79 річних.
- Чисельник: .
- Знаменник: .
- .
У роботі 0.9004 і висновок: інвестор відмовляє, поріг 95 % не пройдено.
Навіщо це потрібно. Звичайний Шарп ураховує два числа (середнє й розкид дохідностей). DSR ураховує ще п'ять: асиметрію, ексцес, довжину ряду, розкид Шарпів за випробуваннями і кількість незалежних випробувань.
3. Що ще є в роботі
Чутливість до кількості випробувань. Той самий Шарп 2.5 пройшов би поріг 95 %, якби стратег перебрав не більше 46 варіантів (DSR 0.9505). За нормальних дохідностей (асиметрія 0, ексцес 3) допустимо до 88 варіантів. Товсті хвости й від'ємна асиметрія майже вдвічі скорочують «бюджет випробувань».
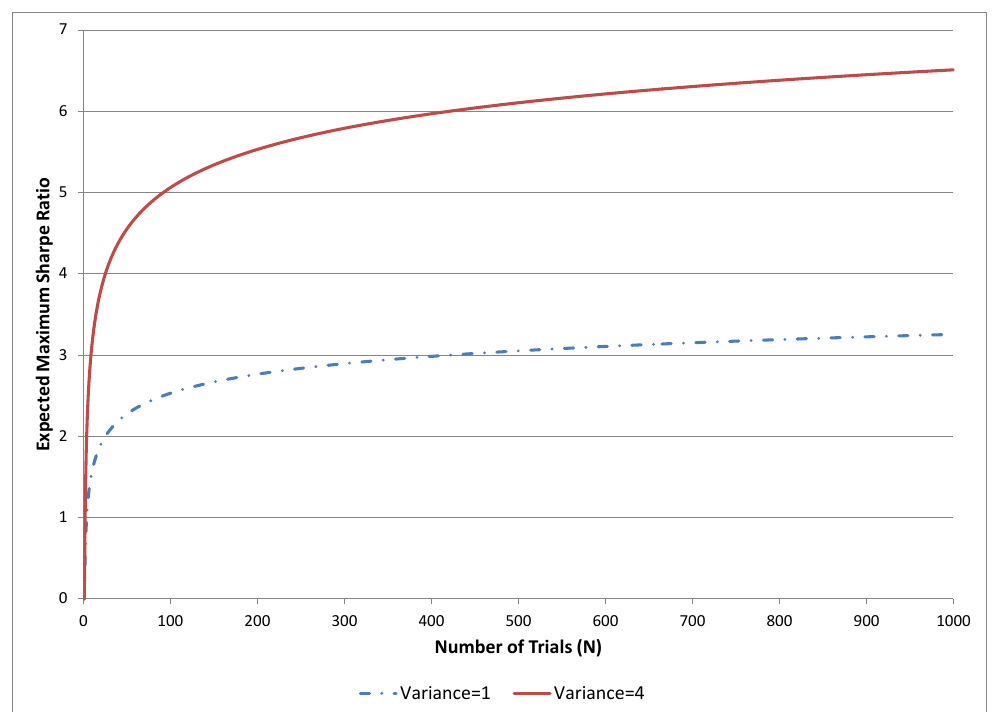
Як його читати. По горизонталі кількість незалежних випробувань до 1 000, по вертикалі очікуваний максимум Шарпа за середнього 0. Синя пунктирна лінія за дисперсії Шарпів 1, червона за дисперсії 4.
Що треба побачити. Крива швидко зростає до сотні випробувань, а далі повільно: до 1 000 випробувань близько 3.3 за дисперсії 1 і близько 6.5 за дисперсії 4.
Практичний висновок. Розкид Шарпів між варіантами важить не менше за їхню кількість: удвічі більше стандартне відхилення Шарпів (дисперсія 4 замість 1) удвічі піднімає поріг.
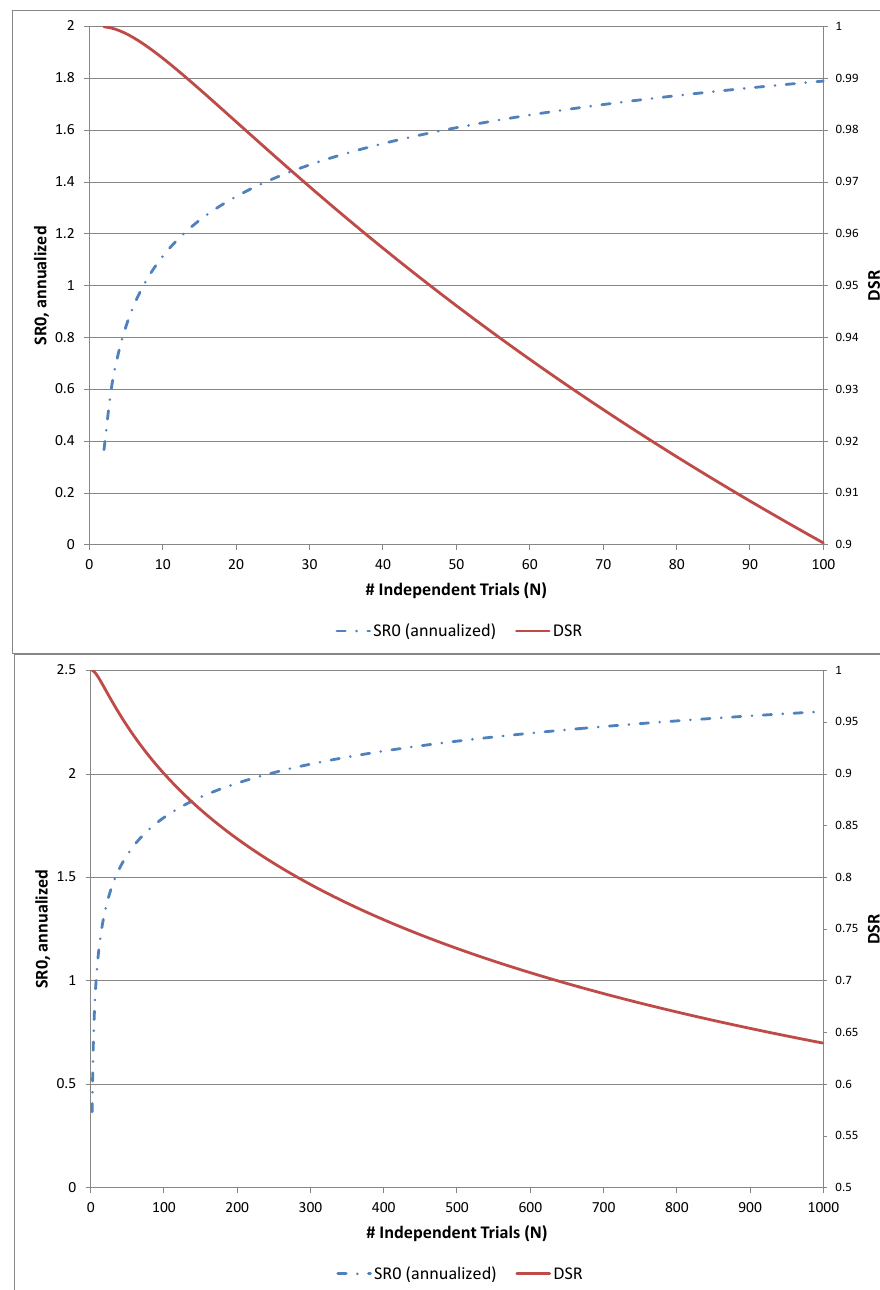
Як його читати. Дві панелі для одного прикладу: до 100 і до 1 000 випробувань. Синій пунктир це поріг у річному вираженні (ліва шкала), червона лінія DSR (права шкала).
Що треба побачити. На верхній панелі DSR падає нижче за 0.95 близько 46 випробувань і доходить до 0.90 до сотні. На нижній до тисячі випробувань DSR близько 0.64 (наш розрахунок за формулою 0.640).
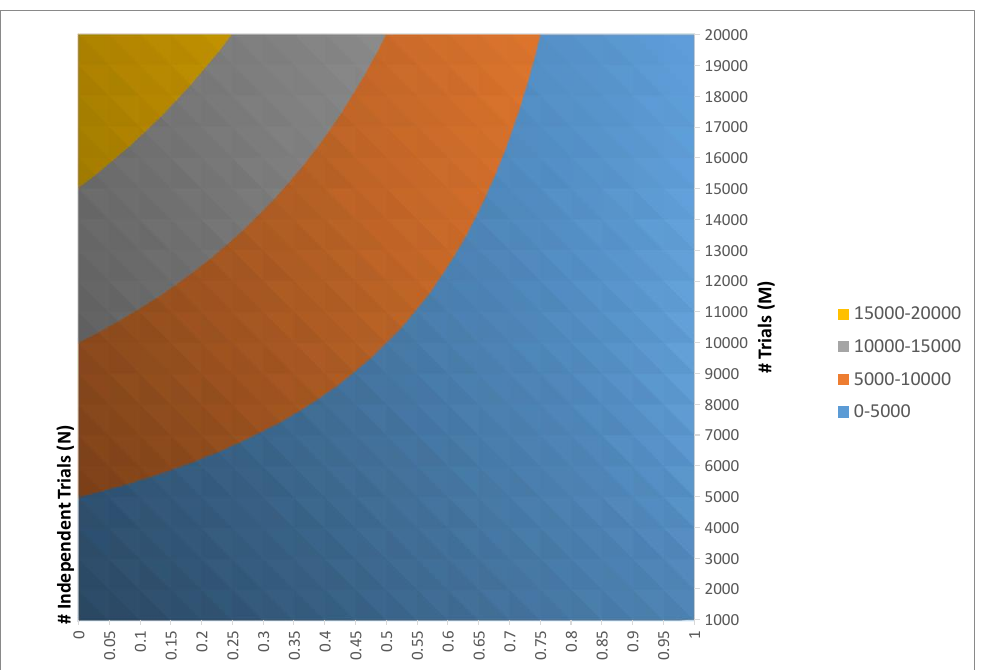
Кількість незалежних випробувань. Якщо випробування корельовані, менше, ніж фактично прогнано (). Автори пропонують через середню кореляцію інтерполяцію
Що це таке. За кореляції 0 усі випробувань незалежні, за кореляції 1 випробування фактично одне; між ними лінійно.
Приклад, наш розрахунок. , : .
і самі відзначають її слабкі місця: кореляція ловить лише лінійну залежність, а коли кількість випробувань більша за довжину ряду, матриця кореляцій погано обумовлена, і оцінка середньої кореляції сама перепідігнана. Як альтернативу вони згадують методи теорії інформації.
Коли зупинитися. Автори пропонують правило оптимальної зупинки («задача про секретаря», закон ): з теоретично обґрунтованих конфігурацій випадково обрати й перевірити близько 37 %, потім перевіряти по одній і зупинитися на першій, яка краща за всі попередні. Це евристика з іншої задачі, самі автори у виносці застерігають, що під час вибору стратегії, на відміну від вихідної задачі, до минулого кандидата повернутися можна.
4. Перевірка формули максимуму в роботі
Автори порівнюють наближення із симуляцією на сітці «середнє × кількість випробувань» по 10 000 повторів (додаток A.2, Exhibit 3.1 і 3.2).
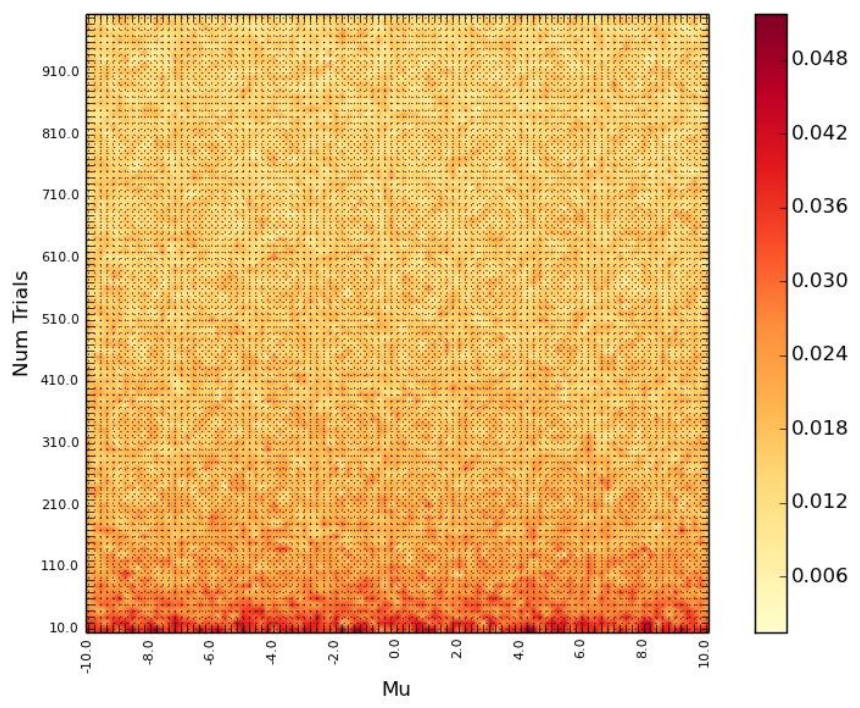
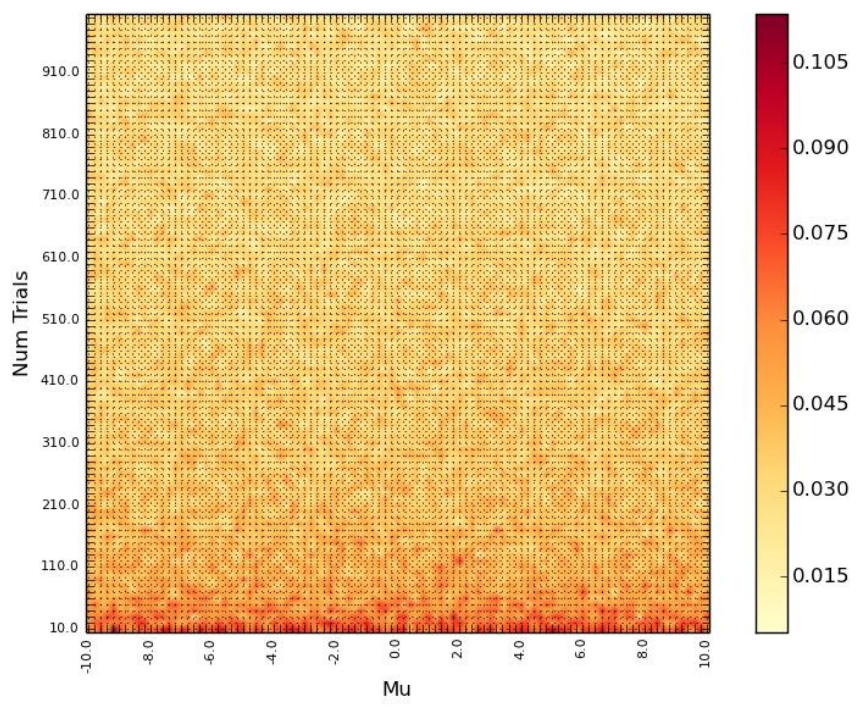
Як читати. По горизонталі середнє Шарпів (Mu), по вертикалі кількість випробувань від 10 до 1 000, колір це похибка «наближення мінус симуляція». Унизу, за малої кількості випробувань, похибка до 0.05 (дисперсія 1) і до 0.11 (дисперсія 4); вище колір рівний, близько 0.012–0.018.
Що треба побачити. Похибка не залежить від середнього (смуги горизонтальні) і завжди додатна: наближення трохи завищує максимум, тобто поріг трохи суворіший, ніж потрібно.
5. Що в роботі хитке
Що знайшлося під час звірки
Чисельний приклад відтворюється до четвертого знака. , DSR 0.9004, за DSR 0.9505, за нормальних дохідностей і теж 0.9505; це останні , за яких DSR не нижчий за 0.95.
Код і рисунок не збігаються щодо діапазону. У Snippet 1 середнє перебирається як np.linspace(-100,100,101), тобто від −100 до 100, а на теплових картах Exhibit 3.1 і 3.2 вісь Mu йде від −10 до 10. Рисунок побудовано не тим кодом, який додано, або код правили пізніше. На висновок не впливає: похибка від середнього не залежить.
До кількості розбіжностей роботи (поле на сайті) входить лише це: розбіжність роботи із самою собою. Усе нижче це наша перевірка, а не суперечність усередині тексту.
Наша перевірка, якої в роботі немає
Точність наближення гірша, ніж написано. Автори: "by 1000 trials it is as small as 0.006 for a process with variance 1" і "The error quickly converges to zero as the number of trials grows". Ми порахували точне сподівання максимуму чисельним інтегруванням: похибка наближення +0.036 за 10 випробувань, +0.023 за 100, +0.014 за 1 000. Вона спадає повільно. Цифра 0.006, судячи з усього, мінімум за клітинками теплової карти, де кожна клітинка зашумлена симуляцією (стандартна похибка близько 0.004), а типовий колір карти на великих якраз 0.012–0.018. Похибка в безпечний бік, поріг трохи завищено.
Формула (9) враховує кореляцію двічі, якщо дисперсію Шарпів узято як розкид між випробуваннями. Робота визначає як "the variance across the trials’ estimated SR", тобто розкид Шарпів між варіантами. За корельованих випробувань цей розкид уже менший за справжню дисперсію кожного Шарпа: спільна частина шуму в усіх однакова і в розкид не потрапляє. Якщо після цього ще й зменшити кількість випробувань за (9), кореляцію враховано двічі, поріг занижено і DSR виходить м'якшим, ніж має бути.
Наш дослід на моделі з однаковою кореляцією між усіма випробуваннями, 1 000 випробувань без майстерності, 4 000 повторів:
| Кореляція | Фактичний середній максимум | за | Те саме з за (9) |
|---|---|---|---|
| 0.0 | 3.237 | 3.256 | 3.256 |
| 0.3 | 2.715 | 2.722 | 2.636 () |
| 0.5 | 2.280 | 2.301 | 2.158 () |
| 0.8 | 1.435 | 1.455 | 1.237 () |
Усі числа в одиницях стандартного відхилення Шарпа одного випробування. У цій моделі правильну відповідь дає за розкиду між випробуваннями; поправка (9) занижує поріг відносно неї на 0.09, 0.14 і 0.22 за кореляції 0.3, 0.5 і 0.8. Якщо ж дисперсію брати не за розкидом між випробуваннями, а як теоретичну дисперсію одного Шарпа, то ефективне має бути набагато меншим, ніж дає (9). Лінійна інтерполяція (9) не випливає ні з того, ні з іншого; автори так і пишуть, що це інтерполяція між крайніми випадками. Наш висновок, модель з однаковою кореляцією наша.
Дрібниці
Підпис Exhibit 3.2 посилається на "Exhibit 2.1", хоча мається на увазі 3.1. Заголовок додатка A.1: "EXPECTED MAXIMUM SHARE RATIO". У тексті Американську статистичну асоціацію названо «Society» і датовано 1997 роком, у списку літератури 1999.
Тонкість у формулюванні. Автори пишуть, що інвестор зрозумів: "there is only a 90% chance that the true SR associated with this strategy is greater than zero". Формально DSR це ймовірність перевищити поріг ; читати її як «шанс, що справжній Шарп більший за нуль» можна лише в логіці роботи, де поріг і є нулем, поправленим на відбір.
6. Що з цього практично випливає
Зберігати кількість випробувань і розкид їхніх Шарпів. Без цих двох чисел DSR не порахувати. Оптимізатор, що зберігає лише переможця, робить перевірку неможливою заднім числом, як і для PBO.
Рахувати Шарп в одиницях одного періоду і брати повний ексцес. Підставити у формулу річний Шарп або надлишковий ексцес замість повного означає отримати безглуздий результат.
Для корельованого перебору параметрів не зменшувати за (9), якщо це розкид Шарпів між варіантами. На нашій моделі чесніше брати , що дорівнює кількості прогонів.
Асиметрія вирішує. Стратегії з рідкісними великими збитками (продаж волатильності, усереднення) отримують набагато менший «бюджет випробувань», ніж трендові з додатною асиметрією.
DSR і PBO доповнюють одне одного. DSR швидкий і потребує п'яти чисел, але спирається на нормальність Шарпів за випробуваннями. PBO непараметричний, але потребує повної матриці дохідностей усіх варіантів.
7. Тестовані ідеї
| № | Ідея | Тип | Де рахувати |
|---|---|---|---|
| 1 | Рахувати DSR для кожного фіналіста: поріг за кількістю незалежних випробувань і розкидом Шарпів усіх випробувань, відсічка 0.95 | метрика приймання | Python |
| 2 | Журнал перебору: кількість випробувань і Шарп кожного, щоб потім порахувати розкид ; без нього DSR не відновити | аудит | будь-яка |
| 3 | Не зменшувати за формулою (9), якщо узято як розкид Шарпів між випробуваннями: кореляція враховується двічі, DSR виходить м'якшим | аудит | Python |
| 4 | Підставляти Шарп за період, а не річний, і повний ексцес (у нормального 3); перевірити на своїх стратегіях, наскільки асиметрія скорочує допустиму кількість випробувань (у прикладі з 88 до 46) | діагностика | Python |
| 5 | Швидкий поріг «випадкового найкращого»: очікуваний максимум з стандартних нормальних (2.53 за 100, 3.26 за 1 000) помножити на розкид Шарпів перебору | діагностика | будь-яка |
| 6 | Перевірити правило зупинки на своїх переборах: скільки випробувань воно заощаджує і чи не втрачає справжній ефект | зміна конструкції | Python |
| 7 | Порахувати на одному переборі і DSR, і PBO, і розібрати випадки, де вони розходяться | метрика приймання | Python |