Как читать этот разбор. Метод работы описывается без единой формулы: разбить историю на куски, много раз поделить куски пополам, выбрать лучший вариант на одной половине и посмотреть, где он оказался на другой. Это раздел «Метод в одну строку». Всё остальное объясняет, что из этого можно вычитать и где метод обманывает. Расхождения с текстом работы в разделе 6.
Главный тезис
Когда исследователь перебирает много вариантов стратегии и выбирает лучший по бэктесту, высокий Шарп лучшего варианта почти ничего не говорит: среди тысяч вариантов на конечной истории всегда найдётся удачливый. Авторы предлагают вопрос, на который можно ответить числом: с какой вероятностью вариант, лучший в выборке, оказывается хуже медианы вне выборки. Это и есть PBO, probability of backtest overfitting.
Чтобы её оценить, не нужно знать, как устроена стратегия. Достаточно матрицы доходностей всех перебранных вариантов. Процедура CSCV (combinatorially symmetric cross-validation) многократно делит историю пополам всеми способами и каждый раз смотрит, куда падает победитель. В отличие от одного отложенного куска данных (hold-out), она использует всю историю и не зависит от того, какой кусок случайно отложили.
На их примере: перебор 8 800 правил «в какой день месяца входить и сколько держать» на чистом случайном блуждании даёт лучший вариант с годовым Шарпом 1.27, а PBO 55 %. Тот же перебор на ряде со встроенным сезонным эффектом даёт PBO 13 %.
1. Как устроена задача
Исследователь прогнал вариантов стратегии на одной истории из наблюдений: разные длины средних, пороги, стопы. У каждого варианта есть ряд доходностей. Он выбирает лучший по Шарпу. Вопрос не в том, прибылен ли лучший вариант в выборке (он прибылен по построению), а в том, сохраняет ли процесс выбора своё преимущество на новых данных.
Авторы определяют переподгонку не через модель, а через ранги: процесс отбора переподогнан, если вариант, лучший в выборке (IS, in-sample), в ожидании оказывается вне выборки (OOS, out-of-sample) ниже медианы всех вариантов. Важная оговорка самих авторов: речь о переподгонке процесса выбора, а не о калибровке одной модели. Поэтому определение не требует знать, что внутри стратегии.
Почему не годится обычный отложенный кусок данных, авторы перечисляют пять причин. Короткая из них: если исследователь пробовал больше одного варианта, переподгонка есть всегда, а hold-out число попыток не учитывает. Остальные: публичные данные исследователь всё равно видел; на коротких рядах отложенный кусок мал; если откладывать конец ряда, теряются самые свежие данные; разные отложенные куски дают разные выводы.
2. Метод в одну строку
Разбить историю на равных кусков, перебрать все способы выбрать половину кусков как обучающие, на каждом найти лучший вариант и посмотреть его ранг на оставшейся половине. PBO равна доле разбиений, где этот ранг ниже медианы.
Пошагово, как в алгоритме 2.3 работы:
- Собрать матрицу размером : в каждом столбце доходности одного варианта, строки синхронны.
- Разрезать строки на чётное число кусков одинаковой длины.
- Перебрать все сочетания из кусков по . Каждое сочетание это обучающая половина , остальные куски это проверочная половина .
- На обучающей половине посчитать Шарп каждого варианта и найти лучший, .
- На проверочной половине посчитать Шарп всех вариантов и определить относительный ранг : , число от 0 до 1.
- Перевести ранг в логит: .
- PBO это доля сочетаний, где , то есть ранг не выше середины.
Что это такое. Число способов выбрать половину кусков. Столько раз повторяется проверка.
Что означает каждый значок. (эс): число кусков. (факториал): произведение всех чисел от 1 до данного.
Пример на числах работы. При (куски A, B, C, D) сочетаний шесть: AB против CD, AC против BD и так далее; это рисунок 1 работы. При их 12 870, при уже 2 704 156.
Зачем это нужно. Каждая половина ровно один раз служит обучением и один раз проверкой, а обе половины одной длины. Поэтому сравнение честное: Шарп в выборке и вне неё оценён на одинаковом объёме данных.
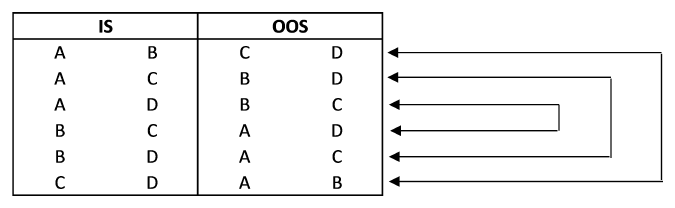
Как его читать. Каждая строка одно сочетание: слева два куска, на которых выбирают лучший вариант (IS), справа два, на которых его проверяют (OOS). Стрелки показывают, что каждое сочетание встречается и в обратной роли.
Что это такое. Логит: перевод ранга из промежутка от 0 до 1 на всю числовую ось. Ноль означает медиану, плюс выше медианы, минус ниже.
Счёт по шагам, наш пример. Из 880 вариантов победитель обучающей половины занял на проверочной 700-е место снизу. Тогда , : хорошо. Если бы он занял 300-е место, , : этот случай идёт в PBO.
Зачем это нужно. Распределение логитов по всем сочетаниям показывает картину целиком: где центр, насколько широк разброс, длинный ли левый хвост.
Авторы рекомендуют : при четырёх годах дневных данных куски получаются кварталами, а 12 870 сочетаний хватает, чтобы долю оценить с точностью около 0.01. Число вариантов должно быть заметно больше десяти, иначе ранги принимают слишком мало значений.
3. Что ещё даёт та же процедура
Кроме PBO, из тех же сочетаний получаются три вещи.
Деградация. Пары «Шарп победителя в выборке, его же Шарп вне выборки» по всем сочетаниям. Регрессия второго на первый обычно даёт отрицательный наклон: чем выше Шарп в выборке, тем ниже вне её. Авторы объясняют это тем, что переподогнанная модель настроена на шум прошлого и потому хуже готова к будущему.
Вероятность убытка. Доля сочетаний, где победитель вне выборки имеет отрицательный Шарп. Авторы подчёркивают, что она может быть высокой и при низкой PBO, тогда стратегия плоха по причинам, не связанным с переподгонкой.
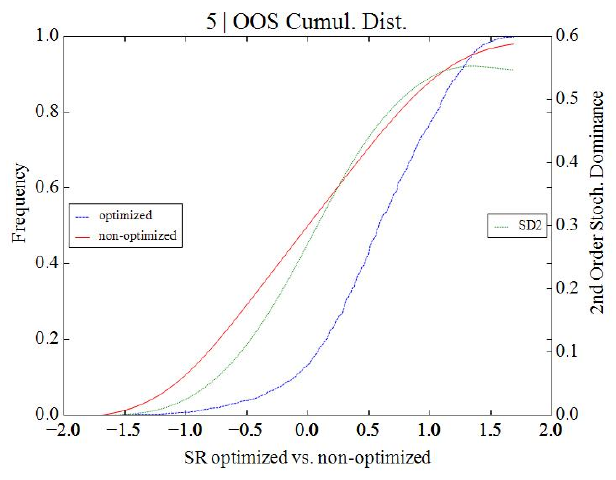
Стохастическое доминирование. Сравнение распределения Шарпа вне выборки у победителей с распределением у всех вариантов. Если победители не доминируют, процедура отбора ничем не лучше случайного выбора варианта.
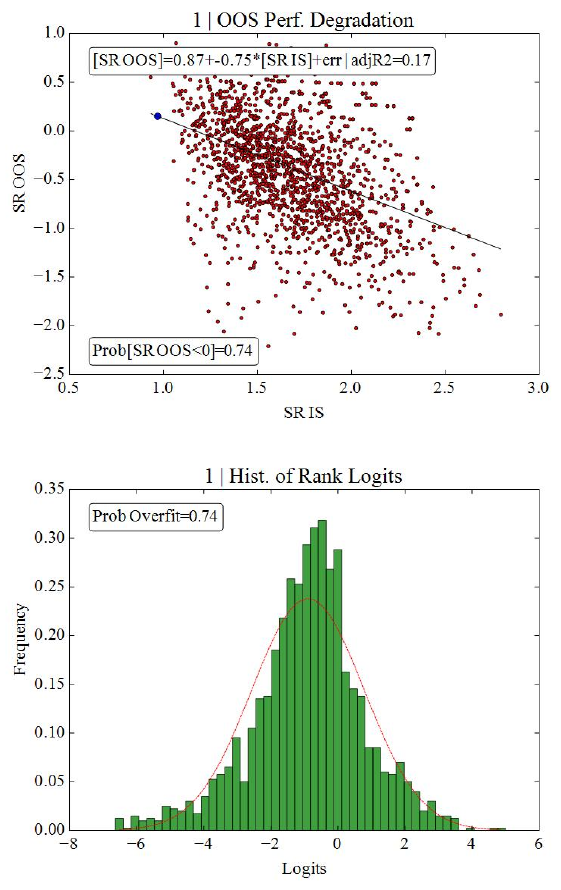
Как его читать. Вверху каждая точка одно сочетание: по горизонтали Шарп победителя в выборке, по вертикали его Шарп вне выборки. Внизу гистограмма логитов. Подписи внутри рисунка:
Prob[SR OOS<0]=0.74иProb Overfit=0.74.Что нужно увидеть. Все Шарпы в выборке от 1 до 3, а вне выборки облако уходит вниз с наклоном −0.75. Логиты сдвинуты влево от нуля.
Практический вывод. Шарп 2–3 в выборке при таком процессе отбора ничего не обещает: вне выборки три четверти победителей убыточны.
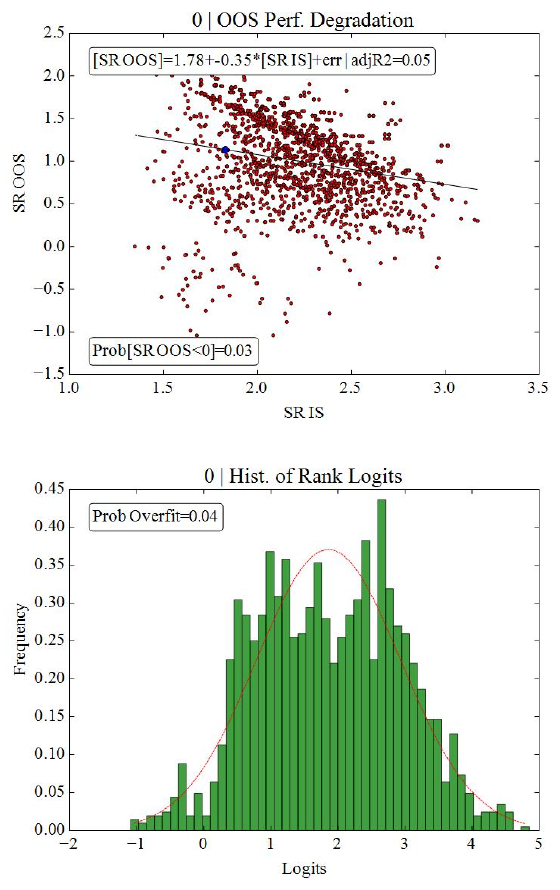
Как его читать. Те же две панели для «реальной инвестиционной стратегии», которую авторы не описывают. Подписи:
Prob[SR OOS<0]=0.03,Prob Overfit=0.04.Что нужно увидеть. Облако выше нуля, наклон −0.35, логиты почти целиком справа. Отрицательный наклон есть и здесь: деградация присуща любому отбору, вопрос в силе.
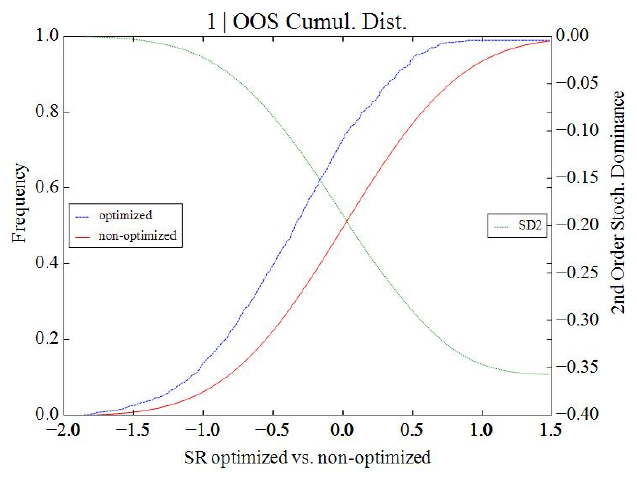
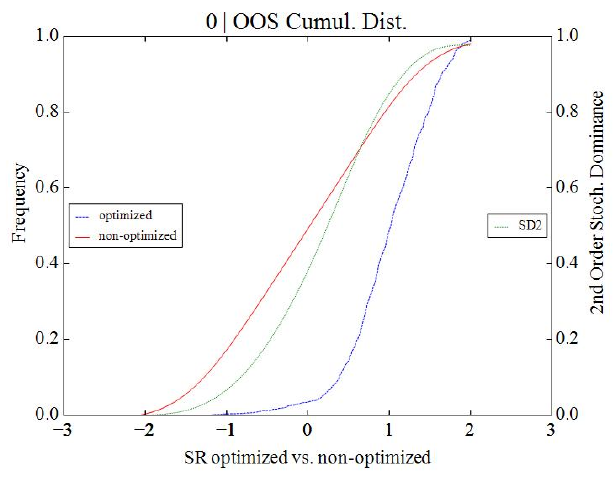
Как читать рисунки 4 и 5. Две функции распределения Шарпа вне выборки: у победителей (optimized) и у всех вариантов (non-optimized), плюс кривая второго порядка доминирования. На рисунке 4 кривая победителей левее, то есть отбор вредит. На рисунке 5 она правее: отбор действительно находит лучшее.
4. Практический пример
Сезонное правило: в какой рабочий день месяца входить (1–22), сколько дней держать (1–20), стоп в волатильностях (у авторов промежуток от 0 до 10), лонг или шорт. Всего, по словам авторов, 8 800 вариантов. Ряд из 1 000 дневных цен, около четырёх лет.
На чистом случайном блуждании лучший вариант (вход на 11-й день, держать 4 дня, стоп −1, лонг) даёт годовой Шарп 1.27, PSR-статистика 2.83, то есть меньше 1 % шанса, что настоящий Шарп ниже нуля. По одному этому бэктесту стратегия выглядит значимой. CSCV даёт: у 53 % сочетаний победитель вне выборки убыточен, PBO 55 %, доминирования нет. Метод правильно диагностирует переподгонку, ведь сезонности в случайном блуждании нет.
С встроенным эффектом (первые пять дней каждого месяца сдвинуты на четверть стандартного отклонения) лучший вариант (вход в 1-й день, держать 4 дня, стоп −10, лонг) даёт Шарп 1.54, почти тот же. Но вне выборки убыточны только 13 % победителей, PBO 13 %, доминирование есть.
Мораль авторов: высокий Шарп в выборке одинаков в обоих случаях, различает их только PBO.
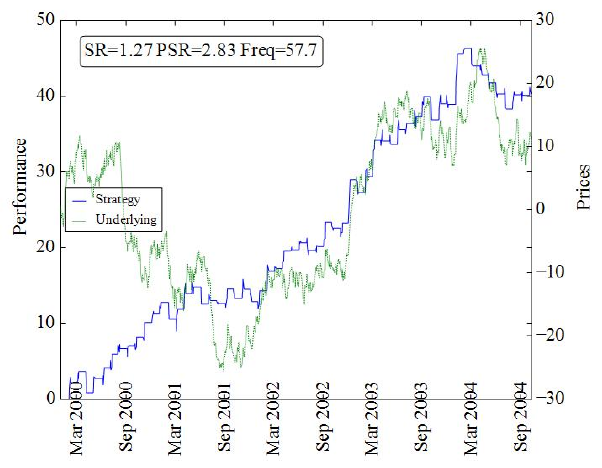
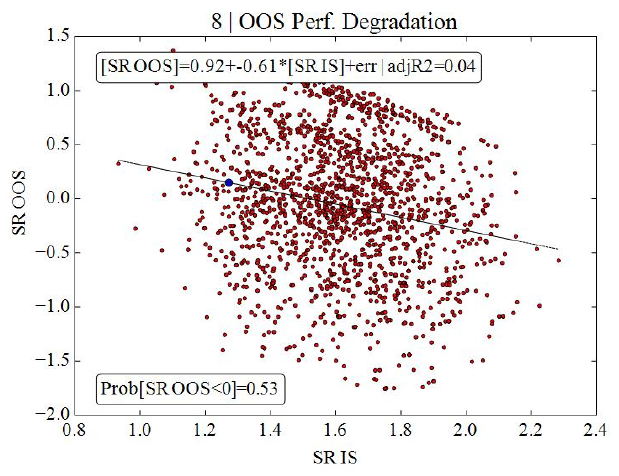
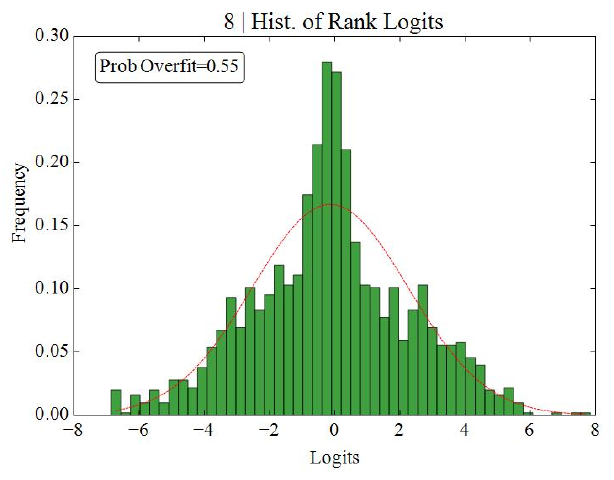
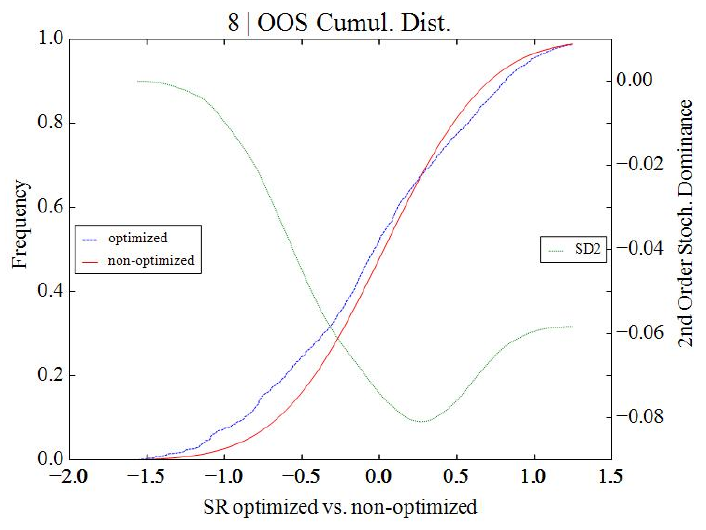
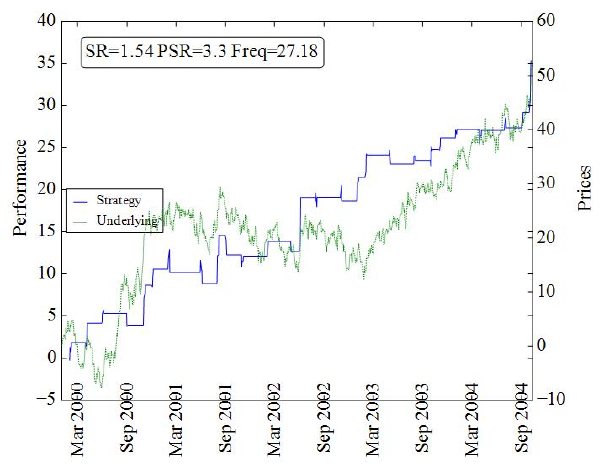
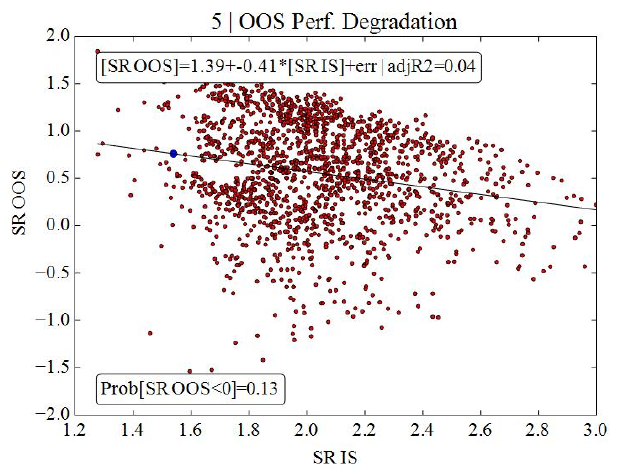
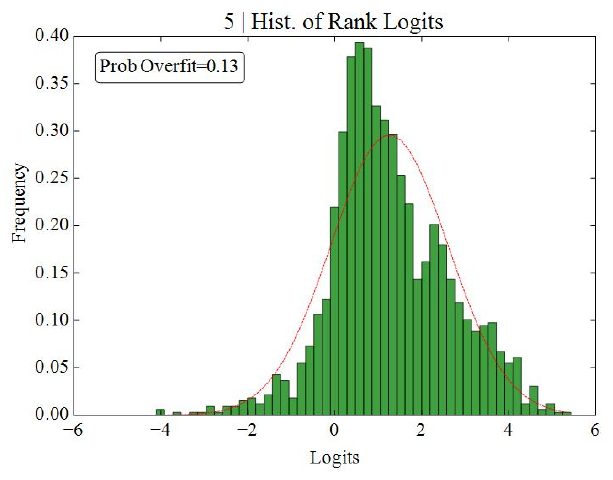
Как читать рисунки 6–13. Рисунки 6 и 10: синяя ступенчатая линия это накопленный результат лучшего варианта, зелёная цена ряда. Оба выглядят как хорошая стратегия. Рисунки 7 и 11: облако пар Шарпов; в первом случае центр облака около нуля, во втором около единицы. Рисунки 8 и 12: логиты; в первом центр у нуля, во втором сдвинут вправо. Рисунки 9 и 13: во втором случае кривая победителей правее.
Практический вывод. По графику капитала лучшего варианта переподгонку не увидеть. Она видна только при сравнении с остальными вариантами на другой половине данных.
Наша проверка на своих рядах
Мы написали CSCV по алгоритму 2.3 и повторили опыт на десяти случайных рядах того же устройства: 1 000 дней, сетка «день входа × срок × сторона» без стопа, 880 вариантов, .
| Ряд | PBO по десяти рядам | Среднее | Работа, один ряд |
|---|---|---|---|
| Случайное блуждание | 0.39 … 0.69 | 0.60 | 0.55 |
| Сдвиг первых 5 дней на +0.25σ | 0.01 … 0.36 | 0.19 | 0.13 |
Качественный вывод работы воспроизводится: с эффектом PBO заметно ниже. Но видно и то, что работа не обсуждает: PBO одного ряда сильно гуляет от ряда к ряду (раздел 6).
5. Ограничения, которые авторы называют сами
Раздел 5 работы честный и полезный, его стоит пересказать близко к тексту.
Конструкция. Деление строго пополам и на равные куски подходит не всем стратегиям; при сильной автокорреляции результатов и большом куски рвут структуру. Все сочетания имеют одинаковый вес; если про распределение результатов что-то известно, специальные схемы могут быть точнее.
Применение. Нужно предъявить все испытания: "Hiding trials will lead to an underestimation of the overfit". Нельзя и добавлять заведомо провальные варианты, чтобы победитель выглядел лучше. Для направленного поиска (оптимизатор, который сам выбирает, куда идти) в матрицу кладутся итоговые решения каждого поиска, а не промежуточные шаги.
Процедура "does nothing to evaluate the correctness of a backtest": неверные издержки или заглядывание вперёд она не ловит.
Структурный сдвиг вне доступной истории она не видит.
Высокая PBO не значит, что хороших стратегий нет: если все вариантов одинаково хороши, победитель случаен, и PBO высока среди сплошь "skillful" стратегий.
И главное предупреждение: использовать PBO как цель оптимизации нельзя, это "would constitute a gross misuse of our method". Любой приём против переподгонки, ставший критерием отбора, сам начинает переподгонять.
6. Что в работе шатко
Что нашлось при сверке
1. Число сочетаний при . В тексте "if S = 16, we will form 12, 780 combinations". По формуле (2.3) работы . Остальные числа сочетаний в работе верны (924 при , 2 704 156 при ). Опечатка, на оценку точности не влияет: и , оба меньше заявленных 0.0045.
2. PBO реальной стратегии в сто раз занижена в одном из двух мест. В разделе 3.2 сначала "was only 4%", через абзац "with a PBO of 0.04%". На самом рисунке 3 стоит Prob Overfit=0.04, то есть доля 0.04, или 4 %. Верно первое.
3. Доля отрицательных Шарпов в примере рисунка 2. В тексте "about 78% of the SR OOS are negative". На рисунке подпись Prob[SR OOS<0]=0.74. Рендер проверен при 300 dpi.
4. В выводах определение PBO перевёрнуто с медианы на среднее. Определение 2.2 и весь текст говорят о ранге ниже медианы. В разделе 7: "the probability that an optimal strategy IS underperforms the mean OOS". Для распределения Шарпов с хвостами медиана и среднее различаются, и это два разных критерия.
5. Логит равномерного ранга не стандартный нормальный. Раздел 4: "the distribution of the logits will approximate the standard Normal". Логит равномерно распределённой величины распределён по стандартному логистическому закону, его стандартное отклонение , а не 1. Наш расчёт на миллионе равномерных чисел: 1.813. Форма похожа на нормальную, масштаб почти вдвое шире. Это важно, если кто-то захочет считать «значимость» среднего логита по нормальной шкале.
6. В шаге c) алгоритма перепутаны выборки. "the nth column of J (the testing set)": в шаге a) определено как обучающая половина, а проверочная половина это из шага b). Из контекста ясно, что имеется в виду обучающая; при переписывании алгоритма в код эта строка вводит в заблуждение.
Мелочь. Сетка примера не сходится по счёту: "the interval [0, . . . , 10] for Stop loss" даёт 11 значений, и тогда , а не "8,800 elements"; 8 800 получается при десяти значениях стопа (у победителей стоп −1 и −10). На выводы не влияет.
Что видно при проверке, но в работе не обсуждается
Точность PBO завышена. Авторы оценивают ошибку доли как у независимых испытаний: при 12 870 сочетаниях стандартное отклонение меньше 0.0045 и "less than a 0.01 estimation error at 95% confidence level". Но сочетания перекрываются, каждое делит куски с тысячами других, и независимыми они не являются. Главное: эта точность описывает разброс по сочетаниям одной истории, а не то, насколько PBO зависит от самой истории. На наших десяти случайных блужданиях PBO одного и того же процесса колеблется от 0.39 до 0.69, а с эффектом от 0.01 до 0.36. Одно число PBO по одной истории неопределённо на десятки процентных пунктов. Наш расчёт.
В сетке с зеркальными вариантами PBO совпадает с вероятностью убытка. Если для каждого правила в переборе есть и лонг, и шорт (у авторов есть параметр Side), то медиана Шарпов вне выборки около нуля, и «ниже медианы» почти то же, что «убыточен». Поэтому у авторов пары чисел так близки: 55 % и 53 %, 13 % и 13 %. На нашей сетке они совпали до сотых: 0.60 и 0.60, 0.19 и 0.19. Две метрики в этом случае не дают независимой информации. Наш вывод.
Порог 0.05 строже, чем выглядит. Авторы допускают "reject models for which PBO is estimated to be greater than 0.05". При разбросе PBO по историям, показанном выше, порог 0.05 на одной истории почти недостижим для стратегии со слабым настоящим эффектом: у нашего ряда с реальной сезонностью PBO ниже 0.05 оказалась в одном случае из десяти.
«Реальная стратегия» не описана. Рисунки 3 и 5 даны без описания стратегии, данных и числа вариантов. Проверить их нельзя.
7. Что из этого практически следует
Хранить все варианты перебора, а не только лучший. PBO считается только по полной матрице доходностей. Оптимизатор, который сохраняет одного победителя, делает метод неприменимым задним числом. На практике это значит сохранять дневные результаты всех конфигураций сетки, а не только итог лучшей.
Число PBO по одной истории читать как грубую оценку. Разброс между историями сравним с самим значением. Надёжнее считать PBO на нескольких инструментах или периодах и смотреть на разброс.
Отрицательный наклон «Шарп вне выборки против Шарпа в выборке» отчитывать рядом с лучшим результатом. Это самая наглядная часть метода и самая дешёвая: тот же перебор, одна регрессия.
Не выбирать стратегию по PBO. Это прямое предупреждение авторов. PBO оценивает процесс отбора, а не стратегию.
Для проп-задач. Подбор размера и настроек под правила оценки тоже перебор (у Hall, 2026, 324 конфигурации в состязательном тесте). Если вместе с лучшей конфигурацией не показано, где она оказывается на другой половине истории, доля прохода в бэктесте ничего не значит.
8. Тестируемые идеи
| № | Идея | Тип | Где считать |
|---|---|---|---|
| 1 | Сохранять дневные доходности всех конфигураций каждого перебора и считать PBO по CSCV с до выбора финалиста | метрика приёмки | бэктестер |
| 2 | Журнал всех испытаний по стратегии, включая брошенные идеи: PBO по неполному набору занижена, это прямо сказано в работе | аудит | любая |
| 3 | Считать PBO на нескольких инструментах или неперекрывающихся периодах и отчитывать разброс; на одной истории значение гуляет на десятки п.п. | метрика приёмки | Python |
| 4 | Отчитывать регрессию «Шарп вне выборки на Шарп в выборке» по сочетаниям CSCV рядом с лучшим результатом; отрицательный наклон и долю отрицательных OOS | метрика приёмки | Python |
| 5 | Проверять стохастическое доминирование победителей над всеми вариантами: если доминирования нет, процедура отбора не лучше случайного выбора | аудит | Python |
| 6 | В сетках с зеркальными (лонг/шорт) вариантами не считать PBO и вероятность убытка двумя независимыми свидетельствами: они совпадают по построению | аудит | любая |
| 7 | Для оптимизатора с направленным поиском класть в матрицу только итоговые решения каждого запуска, а не промежуточные шаги | аудит | Python |
| 8 | Считать среднее и разброс логитов в логистической шкале (), а не в нормальной | аудит | Python |