Як читати цей розбір. Метод роботи описується без жодної формули: розбити історію на шматки, багато разів поділити шматки навпіл, обрати найкращий варіант на одній половині й подивитися, де він опинився на іншій. Це розділ «Метод в один рядок». Усе інше пояснює, що з цього можна вичитати і де метод обманює. Розбіжності з текстом роботи в розділі 6.
Головна теза
Коли дослідник перебирає багато варіантів стратегії й обирає найкращий за бектестом, високий Шарп найкращого варіанта майже нічого не каже: серед тисяч варіантів на скінченній історії завжди знайдеться щасливчик. Автори пропонують питання, на яке можна відповісти числом: з якою ймовірністю варіант, найкращий у вибірці, виявляється гіршим за медіану поза вибіркою. Це і є PBO, probability of backtest overfitting.
Щоб її оцінити, не потрібно знати, як влаштована стратегія. Досить матриці дохідностей усіх перебраних варіантів. Процедура CSCV (combinatorially symmetric cross-validation) багато разів ділить історію навпіл усіма способами і щоразу дивиться, куди потрапляє переможець. На відміну від одного відкладеного шматка даних (hold-out), вона використовує всю історію і не залежить від того, який шматок випадково відклали.
На їхньому прикладі перебір 8 800 правил «у який день місяця входити і скільки тримати» на чистому випадковому блуканні дає найкращий варіант із річним Шарпом 1.27, а PBO 55 %. Той самий перебір на ряді з вбудованим сезонним ефектом дає PBO 13 %.
1. Як влаштована задача
Дослідник прогнав варіантів стратегії на одній історії з спостережень: різні довжини середніх, пороги, стопи. У кожного варіанта є ряд дохідностей. Найкращий обирається за Шарпом. Питання не в тому, чи прибутковий найкращий варіант у вибірці (він прибутковий за побудовою), а в тому, чи зберігає процес вибору свою перевагу на нових даних.
Автори визначають перепідгонку не через модель, а через ранги: процес відбору перепідігнаний, якщо варіант, найкращий у вибірці (IS, in-sample), в очікуванні опиняється поза вибіркою (OOS, out-of-sample) нижче за медіану всіх варіантів. Важливе застереження самих авторів: ідеться про перепідгонку процесу вибору, а не про калібрування однієї моделі. Тому визначення не вимагає знати, що всередині стратегії.
Чому не годиться звичайний відкладений шматок даних, автори пояснюють п'ятьма причинами. Найкоротша з них: якщо дослідник пробував більше одного варіанта, перепідгонка є завжди, а hold-out кількості спроб не враховує. Решта: публічні дані дослідник однаково бачив; на коротких рядах відкладений шматок малий; якщо відкладати кінець ряду, втрачаються найсвіжіші дані; різні відкладені шматки дають різні висновки.
2. Метод в один рядок
Розбити історію на рівних шматків, перебрати всі способи обрати половину шматків як навчальні, на кожному знайти найкращий варіант і подивитися його ранг на решті половини. PBO дорівнює частці розбиттів, де цей ранг нижчий за медіану.
Покроково, як в алгоритмі 2.3 роботи:
- Зібрати матрицю розміром : у кожному стовпці дохідності одного варіанта, рядки синхронні.
- Розрізати рядки на парне число шматків однакової довжини.
- Перебрати всі комбінації з шматків по . Кожна комбінація це навчальна половина , решта шматків це перевірна половина .
- На навчальній половині порахувати Шарп кожного варіанта й знайти найкращий, .
- На перевірній половині порахувати Шарп усіх варіантів і визначити відносний ранг : , число від 0 до 1.
- Перевести ранг у логіт: .
- PBO це частка комбінацій, де , тобто ранг не вищий за середину.
Що це таке. Кількість способів обрати половину шматків. Стільки разів повторюється перевірка.
Що означає кожен значок. (ес): кількість шматків. (факторіал): добуток усіх чисел від 1 до даного.
Приклад на числах роботи. За (шматки A, B, C, D) комбінацій шість: AB проти CD, AC проти BD і так далі; це рисунок 1 роботи. За їх 12 870, за уже 2 704 156.
Навіщо це потрібно. Кожна половина рівно один раз слугує навчанням і один раз перевіркою, а обидві половини однакової довжини. Тому порівняння чесне: Шарп у вибірці й поза нею оцінено на однаковому обсязі даних.
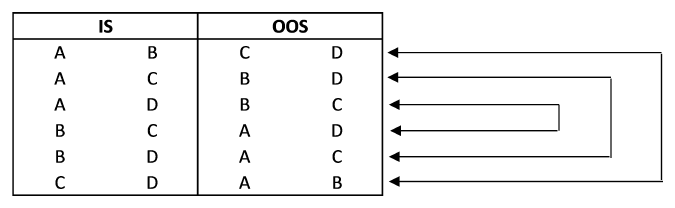
Як його читати. Кожен рядок одна комбінація: ліворуч два шматки, на яких обирають найкращий варіант (IS), праворуч два, на яких його перевіряють (OOS). Стрілки показують, що кожна комбінація трапляється і в зворотній ролі.
Що це таке. Логіт: переведення рангу з проміжку від 0 до 1 на всю числову вісь. Нуль означає медіану, плюс вище за медіану, мінус нижче.
Рахунок за кроками, наш приклад. Із 880 варіантів переможець навчальної половини посів на перевірній 700-те місце знизу. Тоді , : добре. Якби він посів 300-те місце, , : цей випадок іде в PBO.
Навіщо це потрібно. Розподіл логітів за всіма комбінаціями показує картину цілком: де центр, наскільки широкий розкид, чи довгий лівий хвіст.
Автори рекомендують : за чотирьох років денних даних шматки виходять кварталами, а 12 870 комбінацій вистачає, щоб оцінити частку з точністю близько 0.01. Кількість варіантів має бути помітно більшою за десять, інакше ранги набувають надто мало значень.
3. Що ще дає та сама процедура
Крім PBO, з тих самих комбінацій виходять ще три речі.
Деградація. Пари «Шарп переможця у вибірці, його ж Шарп поза вибіркою» за всіма комбінаціями. Регресія другого на перший зазвичай дає від'ємний нахил: що вищий Шарп у вибірці, то нижчий поза нею. Автори пояснюють це тим, що перепідігнана модель налаштована на шум минулого і тому гірше готова до майбутнього.
Імовірність збитку. Частка комбінацій, де переможець поза вибіркою має від'ємний Шарп. Автори наголошують, що вона може бути високою і за низької PBO, і тоді стратегія погана з причин, не пов'язаних із перепідгонкою.
Стохастичне домінування. Порівняння розподілу Шарпа поза вибіркою в переможців із розподілом у всіх варіантів. Якщо переможці не домінують, процедура відбору нічим не краща за випадковий вибір варіанта.
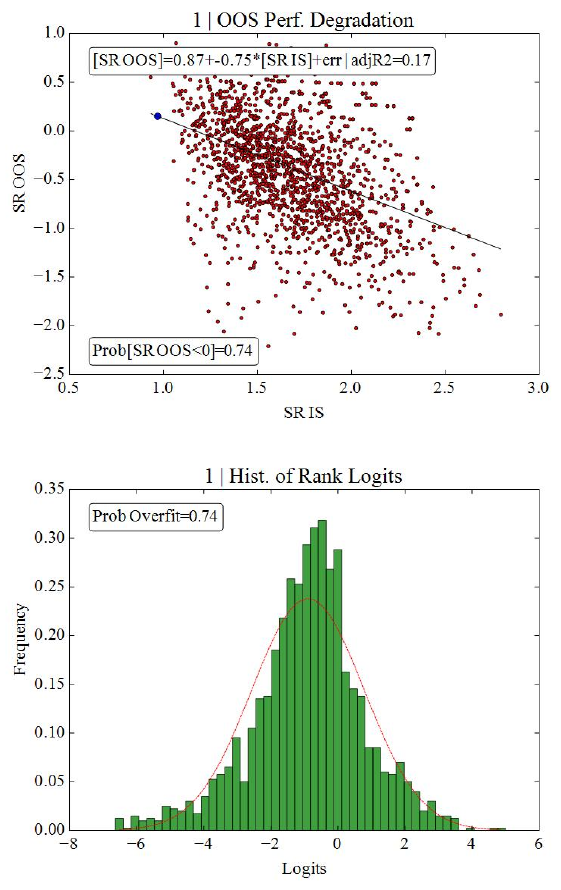
Як його читати. Угорі кожна точка одна комбінація: по горизонталі Шарп переможця у вибірці, по вертикалі його Шарп поза вибіркою. Унизу гістограма логітів. Підписи всередині рисунка:
Prob[SR OOS<0]=0.74іProb Overfit=0.74.Що треба побачити. Усі Шарпи у вибірці від 1 до 3, а поза вибіркою хмара йде вниз із нахилом −0.75. Логіти зсунуті ліворуч від нуля.
Практичний висновок. Шарп 2–3 у вибірці за такого процесу відбору нічого не обіцяє: поза вибіркою три чверті переможців збиткові.
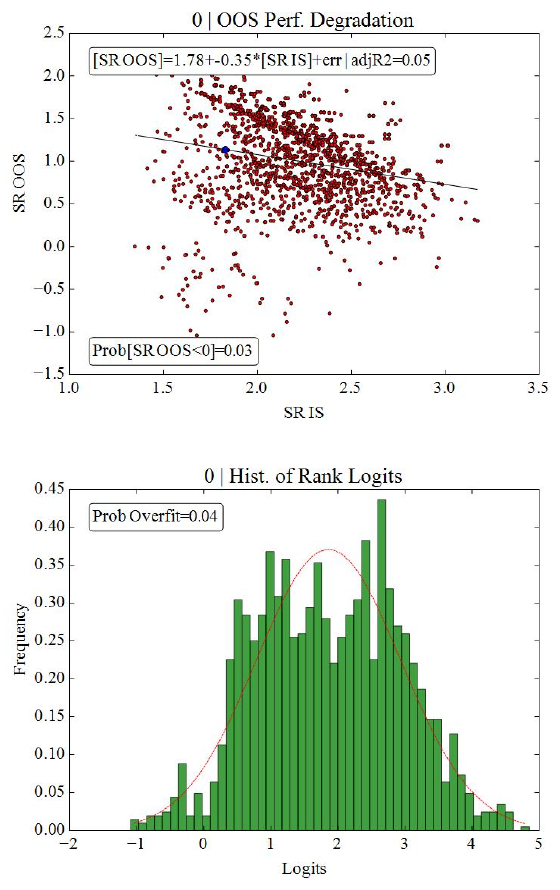
Як його читати. Ті самі дві панелі для «реальної інвестиційної стратегії», яку автори не описують. Підписи:
Prob[SR OOS<0]=0.03,Prob Overfit=0.04.Що треба побачити. Хмара вища за нуль, нахил −0.35, логіти майже цілком праворуч. Від'ємний нахил є і тут: деградація притаманна будь-якому відбору, питання в її силі.
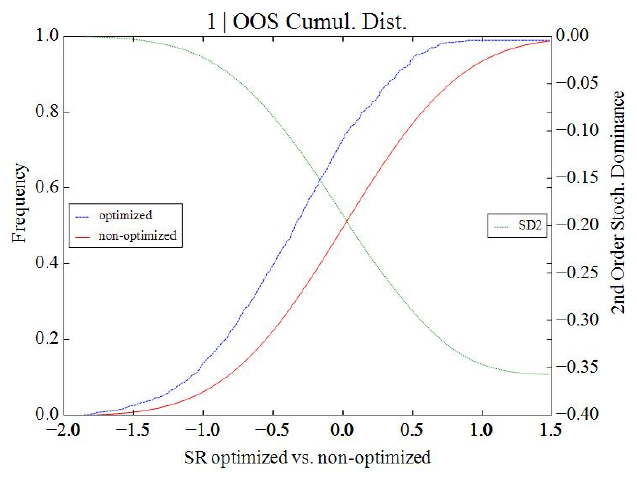
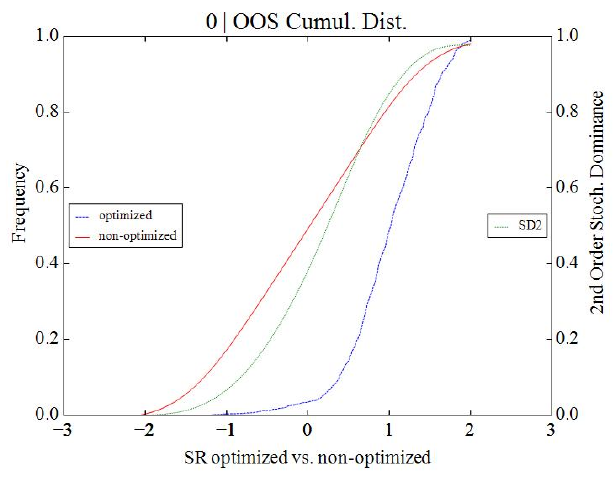
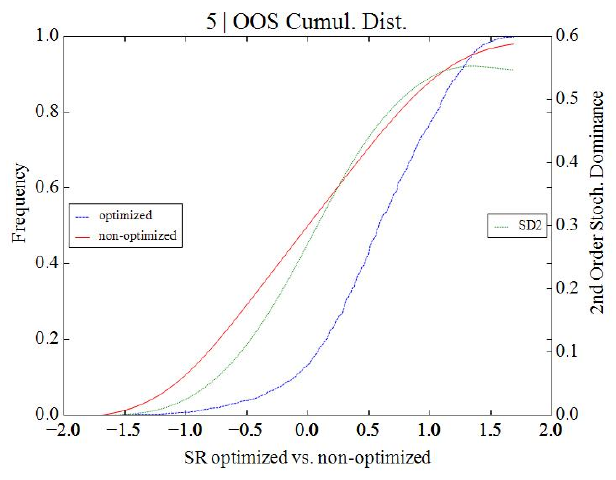
Як читати рисунки 4 і 5. Дві функції розподілу Шарпа поза вибіркою: у переможців (optimized) і в усіх варіантів (non-optimized), плюс крива домінування другого порядку. На рисунку 4 крива переможців лівіше, тобто відбір шкодить. На рисунку 5 вона правіше: відбір справді знаходить краще.
4. Практичний приклад
Сезонне правило: у який робочий день місяця входити (1–22), скільки днів тримати (1–20), стоп у волатильностях (в авторів проміжок від 0 до 10), лонг чи шорт. Усього, за словами авторів, 8 800 варіантів. Ряд із 1 000 денних цін, близько чотирьох років.
На чистому випадковому блуканні найкращий варіант (вхід на 11-й день, тримати 4 дні, стоп −1, лонг) дає річний Шарп 1.27, PSR-статистика 2.83, тобто менше 1 % шансу, що справжній Шарп нижчий за нуль. За одним цим бектестом стратегія виглядає значущою. CSCV дає таке: у 53 % комбінацій переможець поза вибіркою збитковий, PBO 55 %, домінування немає. Метод правильно діагностує перепідгонку, адже сезонності у випадковому блуканні немає.
З вбудованим ефектом (перші п'ять днів кожного місяця зсунуто на чверть стандартного відхилення) найкращий варіант (вхід у 1-й день, тримати 4 дні, стоп −10, лонг) дає Шарп 1.54, майже той самий. Але поза вибіркою збиткові лише 13 % переможців, PBO 13 %, домінування є.
Мораль авторів: високий Шарп у вибірці однаковий в обох випадках, розрізняє їх лише PBO.
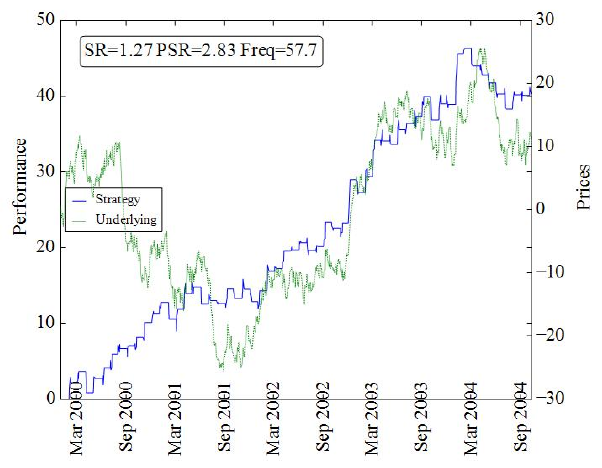
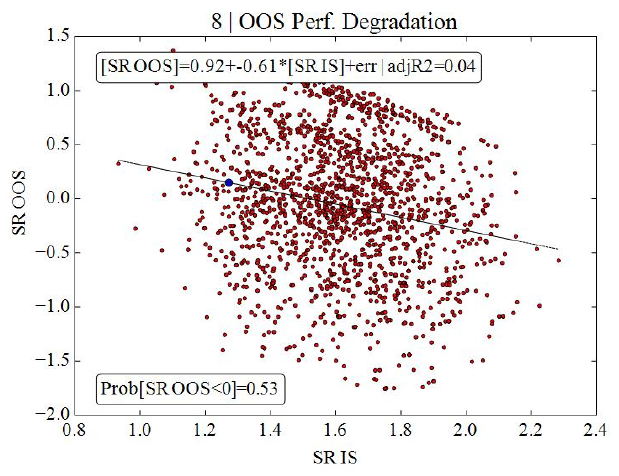
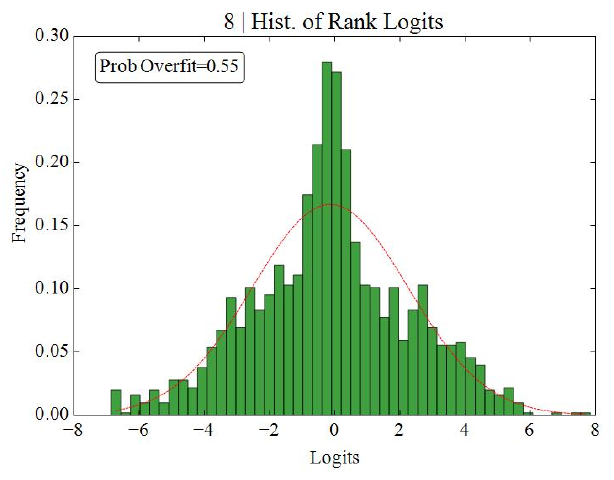
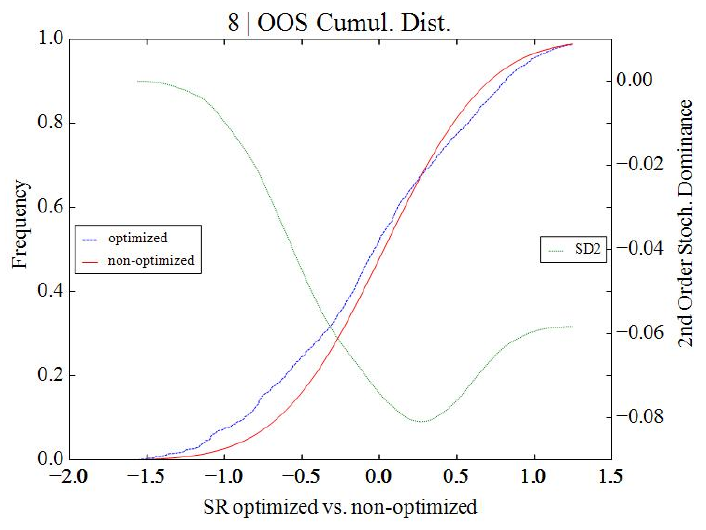
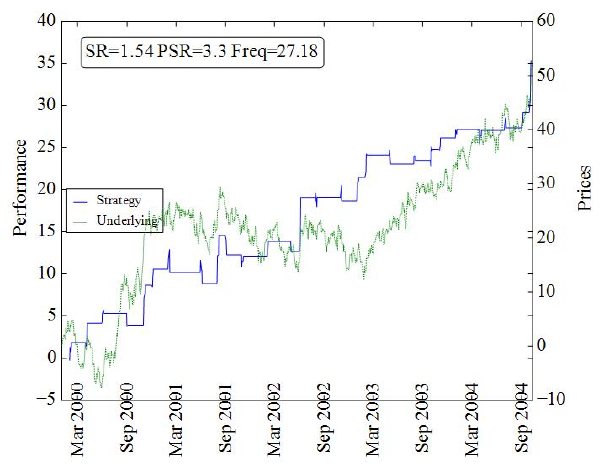
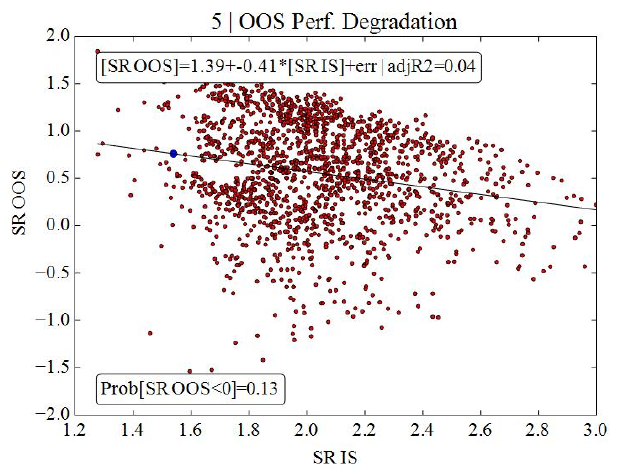
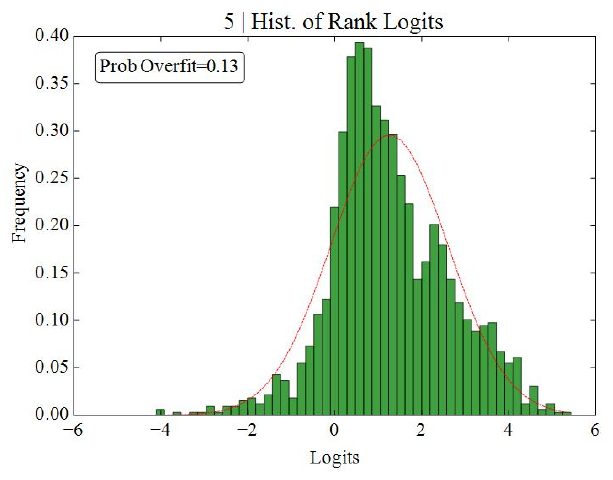
Як читати рисунки 6–13. Рисунки 6 і 10: синя сходинкова лінія це накопичений результат найкращого варіанта, зелена ціна ряду. Обидва виглядають як добра стратегія. Рисунки 7 і 11: хмара пар Шарпів; у першому випадку центр хмари біля нуля, у другому біля одиниці. Рисунки 8 і 12: логіти; у першому центр біля нуля, у другому зсунутий праворуч. Рисунки 9 і 13: у другому випадку крива переможців правіше.
Практичний висновок. На графіку капіталу найкращого варіанта перепідгонку не побачити. Її видно лише в порівнянні з рештою варіантів на іншій половині даних.
Наша перевірка на власних рядах
Ми написали CSCV за алгоритмом 2.3 і повторили дослід на десяти випадкових рядах тієї самої будови: 1 000 днів, сітка «день входу × строк × сторона» без стопу, 880 варіантів, .
| Ряд | PBO за десятьма рядами | Середнє | Робота, один ряд |
|---|---|---|---|
| Випадкове блукання | 0.39 … 0.69 | 0.60 | 0.55 |
| Зсув перших 5 днів на +0.25σ | 0.01 … 0.36 | 0.19 | 0.13 |
Якісний висновок роботи відтворюється: з ефектом PBO помітно нижча. Але видно й те, чого робота не обговорює: PBO одного ряду сильно гуляє від ряду до ряду (розділ 6).
5. Обмеження, які автори називають самі
Розділ 5 роботи чесний і корисний, його варто переказати близько до тексту.
Конструкція. Поділ строго навпіл і на рівні шматки підходить не всім стратегіям; за сильної автокореляції результатів і великого шматки рвуть структуру. Усі комбінації мають однакову вагу; якщо про розподіл результатів щось відомо, спеціальні схеми можуть бути точнішими.
Застосування. Треба пред'явити всі випробування: "Hiding trials will lead to an underestimation of the overfit". Не можна й додавати свідомо провальні варіанти, щоб переможець виглядав краще. Для спрямованого пошуку (оптимізатор, який сам обирає, куди йти) у матрицю кладуть підсумкові розв'язки кожного пошуку, а не проміжні кроки.
Процедура "does nothing to evaluate the correctness of a backtest": неправильних витрат чи зазирання вперед вона не ловить.
Структурного зсуву поза доступною історією вона не бачить.
Висока PBO не означає, що добрих стратегій немає: якщо всі варіантів однаково добрі, переможець випадковий, і PBO висока серед суцільно "skillful" стратегій.
І головне застереження: використовувати PBO як ціль оптимізації не можна, це "would constitute a gross misuse of our method". Будь-який прийом проти перепідгонки, що став критерієм відбору, сам починає перепідганяти.
6. Що в роботі хитке
Що знайшлося під час звірки
1. Кількість комбінацій за . У тексті "if S = 16, we will form 12, 780 combinations". За формулою (2.3) роботи . Решта чисел комбінацій у роботі правильні (924 за , 2 704 156 за ). Одруківка, на оцінку точності не впливає: і , обидва менші за заявлені 0.0045.
2. PBO реальної стратегії в сто разів занижено в одному з двох місць. У розділі 3.2 спочатку "was only 4%", через абзац "with a PBO of 0.04%". На самому рисунку 3 стоїть Prob Overfit=0.04, тобто частка 0.04, або 4 %. Правильне перше.
3. Частка від'ємних Шарпів у прикладі рисунка 2. У тексті "about 78% of the SR OOS are negative". На рисунку підпис Prob[SR OOS<0]=0.74. Рендер перевірено за 300 dpi.
4. У висновках визначення PBO перевернуто з медіани на середнє. Визначення 2.2 і весь текст говорять про ранг нижче за медіану. У розділі 7: "the probability that an optimal strategy IS underperforms the mean OOS". Для розподілу Шарпів із хвостами медіана й середнє різняться, і це два різні критерії.
5. Логіт рівномірного рангу не стандартний нормальний. Розділ 4: "the distribution of the logits will approximate the standard Normal". Логіт рівномірно розподіленої величини розподілений за стандартним логістичним законом, його стандартне відхилення , а не 1. Наш розрахунок на мільйоні рівномірних чисел: 1.813. Форма схожа на нормальну, масштаб майже вдвічі ширший. Це важливо, якщо хтось захоче рахувати «значущість» середнього логіта за нормальною шкалою.
6. У кроці c) алгоритму переплутано вибірки. "the nth column of J (the testing set)": у кроці a) визначено як навчальну половину, а перевірна половина це із кроку b). З контексту зрозуміло, що йдеться про навчальну; під час переписування алгоритму в код цей рядок вводить в оману.
Дрібниця. Сітка прикладу не сходиться за рахунком: "the interval [0, . . . , 10] for Stop loss" дає 11 значень, і тоді , а не "8,800 elements"; 8 800 виходить за десяти значень стопу (у переможців стоп −1 і −10). На висновки не впливає.
Що видно під час перевірки, але в роботі не обговорюється
Точність PBO завищено. Автори оцінюють похибку частки як для незалежних випробувань: за 12 870 комбінацій стандартне відхилення менше за 0.0045 і "less than a 0.01 estimation error at 95% confidence level". Але комбінації перекриваються, кожна ділить шматки з тисячами інших, і незалежними вони не є. Головне: ця точність описує розкид за комбінаціями однієї історії, а не те, наскільки PBO залежить від самої історії. На наших десяти випадкових блуканнях PBO одного й того самого процесу коливається від 0.39 до 0.69, а з ефектом від 0.01 до 0.36. Одне число PBO за однією історією невизначене на десятки відсоткових пунктів. Наш розрахунок.
У сітці з дзеркальними варіантами PBO збігається з імовірністю збитку. Якщо для кожного правила в переборі є і лонг, і шорт (в авторів є параметр Side), то медіана Шарпів поза вибіркою близька до нуля, і «нижче за медіану» майже те саме, що «збитковий». Тому в авторів пари чисел такі близькі: 55 % і 53 %, 13 % і 13 %. На нашій сітці вони збіглися до сотих: 0.60 і 0.60, 0.19 і 0.19. Дві метрики в цьому випадку не дають незалежної інформації. Наш висновок.
Поріг 0.05 суворіший, ніж здається. Автори допускають "reject models for which PBO is estimated to be greater than 0.05". За розкиду PBO між історіями, показаного вище, поріг 0.05 на одній історії майже недосяжний для стратегії зі слабким справжнім ефектом: у нашого ряду з реальною сезонністю PBO нижча за 0.05 виявилася в одному випадку з десяти.
«Реальну стратегію» не описано. Рисунки 3 і 5 наведено без опису стратегії, даних і кількості варіантів. Перевірити їх не можна.
7. Що з цього практично випливає
Зберігати всі варіанти перебору, а не лише найкращий. PBO рахується лише за повною матрицею дохідностей. Оптимізатор, що зберігає одного переможця, робить метод незастосовним заднім числом. На практиці це означає зберігати денні результати всіх конфігурацій сітки, а не лише підсумок найкращої.
Число PBO за однією історією читати як грубу оцінку. Розкид між історіями порівнянний із самим значенням. Надійніше рахувати PBO на кількох інструментах або періодах і дивитися на розкид.
Звітувати від'ємний нахил «Шарп поза вибіркою проти Шарпа у вибірці» поряд із найкращим результатом. Це найнаочніша частина методу й найдешевша: той самий перебір, одна регресія.
Не обирати стратегію за PBO. Це пряме застереження авторів. PBO оцінює процес відбору, а не стратегію.
Для проп-задач. Підбір розміру й налаштувань під правила оцінки теж перебір (у Hall, 2026, 324 конфігурації в змагальному тесті). Якщо разом із найкращою конфігурацією не показано, де вона опиняється на іншій половині історії, частка проходження в бектесті нічого не означає.
8. Тестовані ідеї
| № | Ідея | Тип | Де рахувати |
|---|---|---|---|
| 1 | Зберігати денні дохідності всіх конфігурацій кожного перебору й рахувати PBO за CSCV з до вибору фіналіста | метрика приймання | бектестер |
| 2 | Журнал усіх випробувань за стратегією, включно з покинутими ідеями: PBO за неповним набором занижена, це прямо сказано в роботі | аудит | будь-яка |
| 3 | Рахувати PBO на кількох інструментах або періодах, що не перекриваються, і звітувати розкид; на одній історії значення гуляє на десятки в. п. | метрика приймання | Python |
| 4 | Звітувати регресію «Шарп поза вибіркою на Шарп у вибірці» за комбінаціями CSCV поряд із найкращим результатом; від'ємний нахил і частку від'ємних OOS | метрика приймання | Python |
| 5 | Перевіряти стохастичне домінування переможців над усіма варіантами: якщо домінування немає, процедура відбору не краща за випадковий вибір | аудит | Python |
| 6 | У сітках із дзеркальними (лонг/шорт) варіантами не вважати PBO та ймовірність збитку двома незалежними свідченнями: вони збігаються за побудовою | аудит | будь-яка |
| 7 | Для оптимізатора зі спрямованим пошуком класти в матрицю лише підсумкові розв'язки кожного запуску, а не проміжні кроки | аудит | Python |
| 8 | Рахувати середнє й розкид логітів у логістичній шкалі (), а не в нормальній | аудит | Python |