Як читати цей розбір. Робота відповідає на два питання: хто з індексу і двох ETF на нього випереджає і на скільки мілісекунд, і як це випередження змінюється в дні, коли надходить нова інформація. Метод вимірювання випередження, який стане в пригоді для будь-якої пари інструментів з несинхронними угодами, розібрано в розділах 2 і 3 з формулами і числами. Результати в розділах 5 і 6. Якщо потрібен лише практичний висновок, читайте розділи 7, 8 і 9: торгова перевірка в роботі одна фраза, і про це треба знати до того, як на неї посилатися.
1. Як влаштована задача
Випередження (lead-lag) це ситуація, коли один інструмент повторює рухи іншого із затримкою. Якби ринок був ефективним і без тертя, у споріднених інструментів, наприклад індексу і фонду на цей індекс, дохідності збігалися б у часі. На практиці випередження знаходять постійно, особливо між ф'ючерсом та індексом. Огляд літератури в роботі дає орієнтири за старими дослідженнями: ф'ючерс випереджає індекс на час до 45 хвилин, індекс ф'ючерс не більше 15 хвилин; при цьому Brooks і співавтори (2001) виявили, що точні прогнози на випередженні після врахування витрат не обганяють еталон.
Автори беруть три інструменти на один і той самий індекс: сам S&P 500 і два найліквідніші ETF на нього, SPY (State Street) і IVV (BlackRock). Усі три торгуються електронно і всі спотові, тому пояснення через різну вартість торгівлі і різний механізм торгів (електронний або в залі), якими література пояснювала випередження ф'ючерса, тут, на думку авторів, не працюють. Залишається швидкість, з якою інструменти відображають нову інформацію.
Вимірювати доводиться на тиках, а не на барах. Автори посилаються на Huth і Abergel (2014): електронна торгівля скоротила затримку настільки, що дані з регулярною сіткою її більше не ловлять. А на тиках виникає інша проблема: угоди за двома інструментами відбуваються в різні моменти, і вирівняти їх за сіткою без спотворень не можна.
Що таке ефект Еппса. Спостереження Epps (1979): що частіше заміряють ціни, то нижча кореляція між інструментами, навіть між майже однаковими. Індекс і фонд на нього на денних даних корелюють на 99.9 %, а на тиках близько 20 %. Причини в несинхронності угод і в тому, що на дуже короткому масштабі спільна інформація ще не встигла дійти до обох цін.
2. Метод в один рядок
Порахувати кореляцію двох тикових рядів без вирівнювання за сіткою (перемножувати дохідності лише на проміжках між угодами, що перетинаються), потім зсувати один ряд у часі з кроком 10 мс і шукати зсув, за якого кореляція максимальна. Положення піку це час випередження, висота піку це кореляція випередження, асиметрія всієї кривої це відношення випередження.
Методику взято в Alsayed і McGroarty (2014): кореляція за Hayashi і Yoshida (2005), її розширення на зсуви за Hoffmann, Rosenbaum і Yoshida (2013), відношення випередження за Huth і Abergel (2014). Внесок роботи не в методі, а в тому, що ці три величини рахуються за кожним днем і пояснюються денним обсягом.
3. Як рахують випередження
3.1 Кореляція без вирівнювання
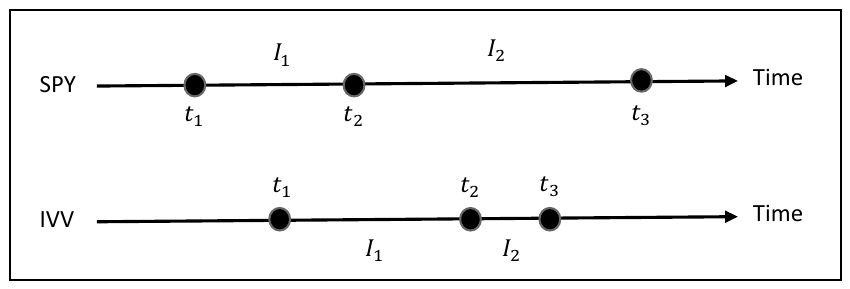
Як його читати. Дві осі часу. Точки це моменти угод, час надходження спостереження, проміжок між двома сусідніми угодами одного інструмента.
Що треба побачити. У SPY і IVV угоди йдуть у різні моменти, і проміжки різної довжини. Взяти «дохідність за ту саму секунду» в обох не можна: усередині секунди в одного може бути багато угод, в іншого жодної.
Що це таке. Коваріація за Hayashi і Yoshida: формула (1) роботи.
Що означає кожен значок. («ер СПАЙ на проміжку і-тому»): дохідність SPY між двома його сусідніми угодами. : те саме для IVV на його проміжку. : індикатор, дорівнює 1, якщо проміжки хоч трохи перетинаються в часі, і 0, якщо ні. («перетин»), («порожня множина»): запис читається «у проміжків є спільна частина».
Рахунок за кроками. Перебрати всі пари «проміжок SPY, проміжок IVV». Якщо перетинаються, перемножити дохідності і додати до суми. Якщо ні, пропустити. Жодних добудованих точок.
Приклад за рисунком 2. Автори перелічують пари, що перетинаються: (, ), (, ) і (, ). Перший проміжок SPY короткий і зачіпає лише перший проміжок IVV, другий довгий і зачіпає обидва.
Що це таке. Формули (2)–(4) роботи: «стандартне відхилення» кожного ряду як корінь із суми квадратів його власних дохідностей і кореляція як коваріація, поділена на їхній добуток. Кожен ряд рахується за своїми проміжками, без синхронізації.
Приклад на числах (наш приклад). Дохідності SPY на двох проміжках +0.02 % і −0.01 %, IVV +0.03 % і −0.02 %, перетини як на рисунку 2. Коваріація . Відхилення і . Кореляція .
Навіщо це потрібно. Це стандартний спосіб рахувати кореляцію пари з несинхронними угодами. Інтерполяція і вирівнювання за сіткою, за словами авторів, вносять зміщення, яких цей спосіб уникає.
3.2 Зсув і крива кореляції
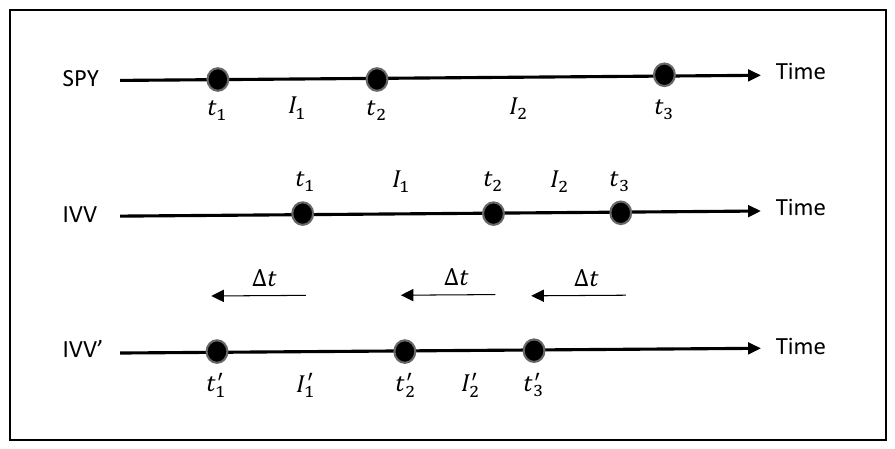
Як його читати. IVV' це копія ряду IVV, у якій кожне спостереження зсунуто назад у часі на ту саму величину . Потім кореляція перераховується між SPY і IVV'.
Що треба побачити. Якщо IVV повторює за SPY із затримкою, зсув IVV назад вирівнює реакцію з причиною, і кореляція зростає. Зсув, за якого вона найбільша, і є затримка.
Що це таке. Формула (5) роботи: та сама кореляція Hayashi–Yoshida, але зі зсунутим рядом. Штрих означає «після зсуву»; перевіряє перетин проміжків SPY з уже зсунутими проміжками IVV.
Як будується крива. перераховується для від −100 до +100 мс із кроком 10 мс, усього 21 значення. У парі SPY–IVV зсувається IVV, у парах з індексом зсувається індекс, а ETF залишається на місці.
Як читати результат. Пік за нуля: випередження немає. Пік за від'ємного зсуву: інструмент, що зсувається, відстає на цю величину. Пік за додатного: випереджає.
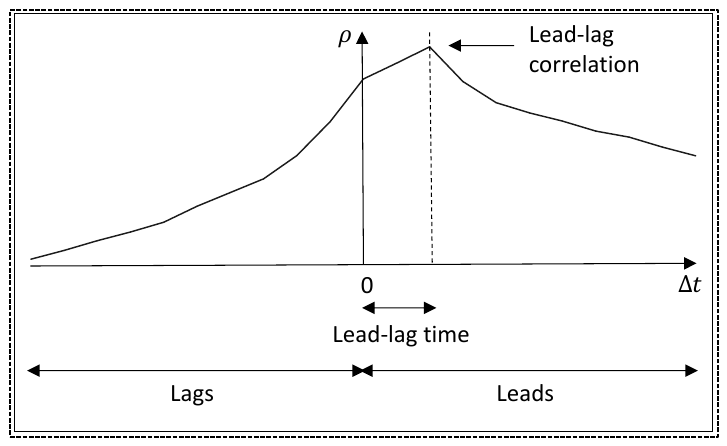
Як його читати. Висота піку називається кореляцією випередження (lead-lag correlation), його положення по горизонталі часом випередження (lead-lag time). Ліворуч від нуля бік відставання (lags), праворуч бік випередження (leads).
3.3 Відношення випередження
Що це таке. Формула (6) роботи, відношення випередження (lead-lag ratio) за Huth і Abergel: наскільки крива кореляції вища на боці випередження, ніж на боці відставання.
Що означає кожен значок. У чисельнику сума квадратів кореляцій за всіх додатних зсувів (10 точок від +10 до +100 мс), у знаменнику за всіх від'ємних (від −10 до −100 мс). Більше одиниці: інструмент, що зсувається, частіше веде, ніж іде слідом.
Приклад на числах (наш розрахунок). У пари індекс–IVV кореляції на кривій близько 0.193–0.194. Десять квадратів на кожному боці дають суму близько . LLR = 1.0058 з таблиці 3 означає, що сума на боці випередження більша за суму на боці відставання всього на 0.58 %.
Навіщо потрібна третя величина. Пік описує одну точку кривої. Автори показують окремою схемою випадок, коли пік стоїть на боці випередження, а вся крива вища на боці відставання.
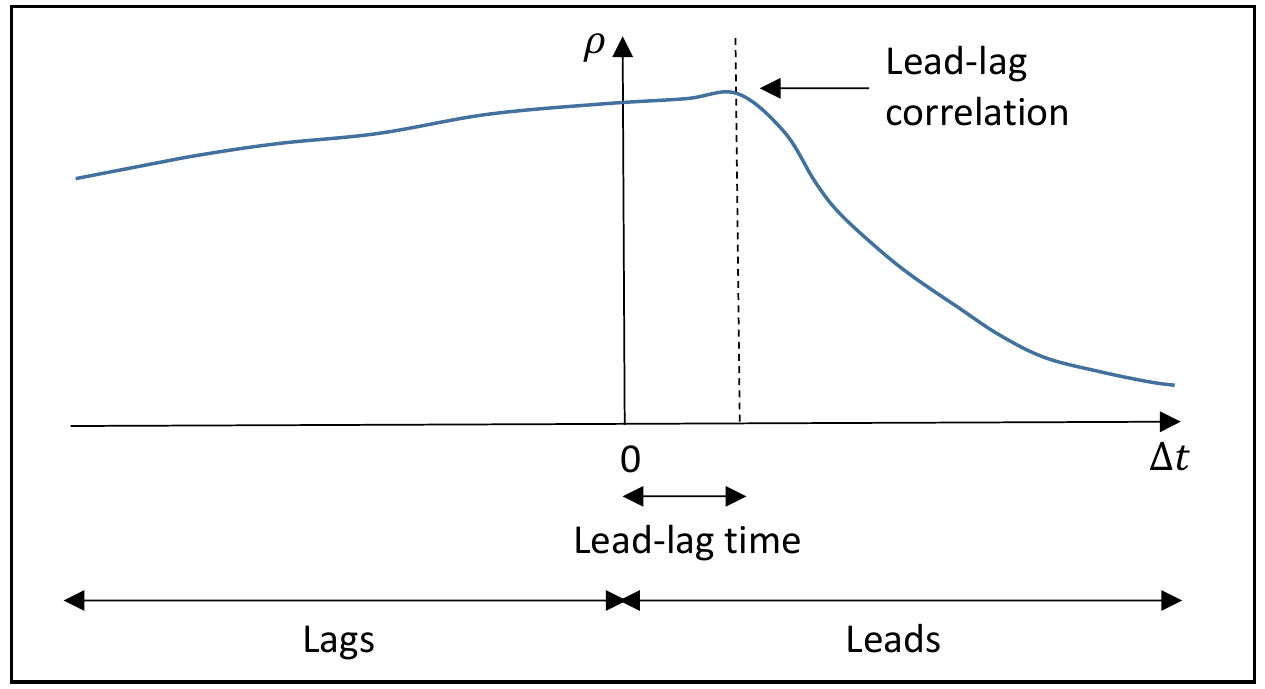
Як його читати. Пік кривої стоїть праворуч від нуля, на боці випередження, тому за піком інструмент, що зсувається, веде. Але ліворуч крива майже скрізь вища, ніж праворуч після піку, і LLR буде меншим за одиницю: за всією кривою цей інструмент радше відстає.
Практичний висновок. Звітувати треба обидві величини. Пік і відношення випередження можуть вказувати в різні боки.
4. Дані
Індекс S&P 500 і два ETF, SPY і IVV, із серпня 2014 до липня 2015 року, з бази Thomson Reuters Tick History, з мітками часу до мілісекунди. Для індексу беруться значення, для ETF ціни угод. Враховується лише основна сесія з 9:30 до 16:00. Очищення за Marshall і співавторами (2013): викинуто спостереження з логарифмічною дохідністю більше 25 % за модулем і спостереження в перші й останні п'ять хвилин сесії. У виносці автори пишуть, що за порогів 5, 15, 35 і 45 % результати ті самі.
Після очищення (таблиця 1): 17 745 864 спостереження індексу, 4 117 085 у SPY і 281 734 у IVV. Медіанна дохідність в усіх нульова, бо багато угод поспіль ідуть за тією самою ціною. Середній денний обсяг (таблиця 2): 525 млн акцій в індексу, 29.9 млн у SPY, 0.77 млн у IVV.
5. Хто кого випереджає
Таблицю 3 роботи пораховано за всією вибіркою відразу, а не за днями.
| Пара (перший лідер) | Кореляція випередження | Час випередження, мс | LLR |
|---|---|---|---|
| S&P 500 – IVV | 0.1943 | 10 | 1.0058 |
| S&P 500 – SPY | 0.1886 | 30 | 1.0230 |
| IVV – SPY | 0.2370 | 20 | 1.0284 |
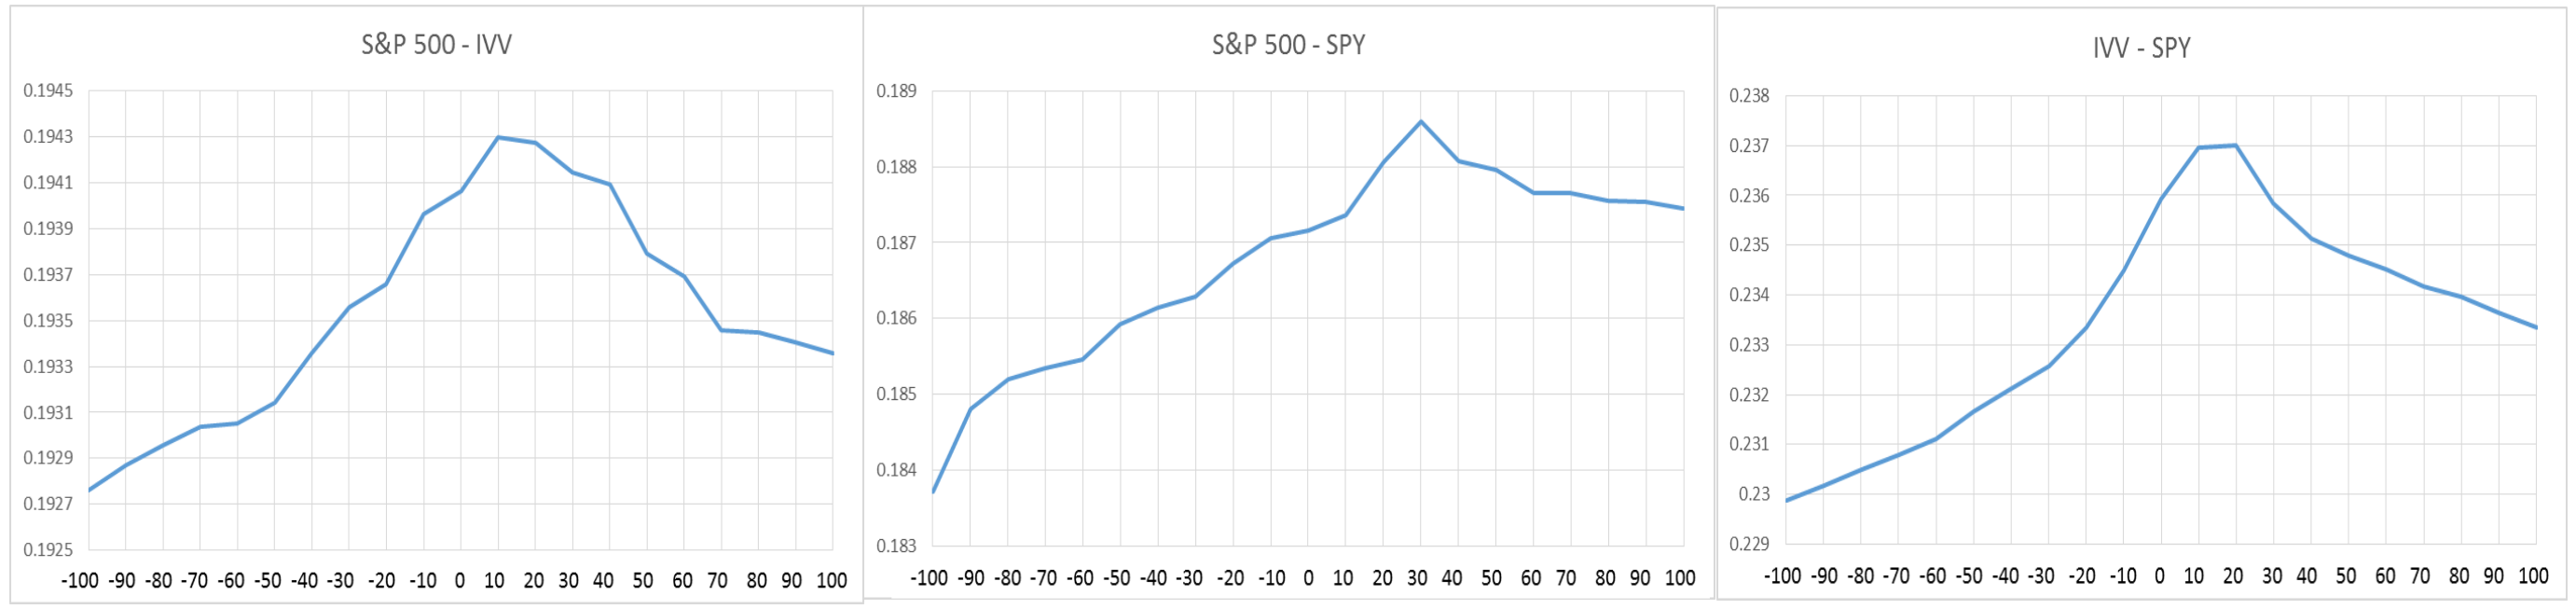
Як його читати. По горизонталі зсув мітки часу першого інструмента пари в мілісекундах, по вертикалі кореляція. Автори рознесли криві на три графіки, бо на спільному всі три виглядали б прямими: діапазон кореляції в кожної пари дуже вузький. Зверніть увагу на вертикальні осі: у пари індекс–IVV увесь графік уміщується між 0.1925 і 0.1945.
Що треба побачити. У всіх трьох кривих пік праворуч від нуля, перший інструмент пари веде. Від піку кореляція плавно спадає в обидва боки. Крива ETF–ETF гладкіша, криві з IVV симетричніші за криву індекс–SPY. У пари IVV–SPY значення за +10 і +20 мс майже рівні.
Практичний висновок. Уся різниця між «випереджає» і «не випереджає» тут лежить у третьому знаку кореляції. Вимірювання потребує мільйонів спостережень, і його точність обмежена кроком сітки 10 мс.
Висновок авторів: індекс випереджає обидва фонди, "so price discovery starts from the index and the ETFs follow" (розділ 5.1). Кореляція фондів між собою вища, ніж з індексом, а LLR трохи більше одиниці і найвищий у пари фондів.
6. Як на випередження впливає надходження інформації
Інформацію безпосередньо не видно, тому автори беруть стандартний замінник: обсяг торгів. Денний обсяг кожного інструмента ділиться за двома ознаками.
Блоковий і неблоковий. Блокові угоди, великі за кількістю або вартістю акцій, за Madhavan і Sofianos (1998) зазвичай ініціюють інституційні учасники. Автори використовують їх як замінник «досвідчених» учасників. Неблоковий обсяг це загальний мінус блоковий.
Очікуваний і несподіваний. За Bessembinder і Seguin (1993) очікуваний обсяг дня дорівнює вчорашньому, несподіваний це різниця:
Що це таке. Формули (8) і (9) роботи для блокового обсягу; для неблокового (10) і (11) влаштовано так само.
Що означає кожен значок. : блоковий обсяг дня . : очікуваний блоковий обсяг, просто вчорашній. : несподіваний блоковий обсяг, приріст до вчорашнього. Несподіваний обсяг слугує замінником надходження інформації, очікуваний звичайного рівня активності.
Приклад на числах (наш приклад). Учора блоковий обсяг SPY 5 млн акцій, сьогодні 8 млн. Очікуваний 5, несподіваний +3 млн. Якщо сьогодні 4 млн, несподіваний −1 млн.
Кожен із трьох показників випередження (кореляція, час, LLR) за кожним днем регресується на чотири компоненти обсягу обох інструментів пари (формула 12 роботи):
Що означає кожен значок. : показник випередження дня . : чотири компоненти обсягу (очікуваний і несподіваний, блоковий і неблоковий) у мільйонах акцій. , : коефіцієнти, які й шукаються. : залишок. Для пари двох фондів у регресію додано ще й обсяг індексу (формула 13), усього 12 змінних.
Результати за LLR, силою лідерства (таблиця 4, панель C). Це головний результат роботи.
- Індекс–IVV: несподіваний обсяг лідера (індексу) посилює лідерство, коефіцієнти +0.00196 при блоковому і +0.00045 при неблоковому, обидва значущі на 1 %.
- IVV–SPY: несподіваний обсяг відстаючого (SPY) послаблює лідерство, −0.00246 при блоковому (1 %) і −0.00227 при неблоковому (5 %).
- Індекс–SPY: жодного значущого коефіцієнта при обсязі.
Результати за кореляцією випередження (панель A). Тут знак залежить від пари. У парі індекс–IVV зростання несподіваного обсягу лідера знижує кореляцію (−0.00073 при блоковому, 5 %), а зростання обсягу відстаючого її підвищує (+0.05245 при блоковому, 5 %, і +0.03540 при неблоковому, 10 %). У двох інших парах навпаки: у парі IVV–SPY несподіваний блоковий обсяг лідера IVV підвищує кореляцію (+0.04518, 5 %), а несподіваний обсяг відстаючого SPY знижує (−0.00118 при блоковому, 5 %, −0.00112 при неблоковому, 10 %). Автори так і формулюють: ефект на кореляцію в лідера і відстаючого протилежний, але його напрямок різниться між парами.
Результати за часом випередження (панель B). Жоден коефіцієнт при обсязі не значущий. Вільні члени 9.0 мс, 23.9 мс і 15.4 мс.
Скоригований регресій від 0.209 до 0.275 для кореляції, від 0.113 до 0.151 для часу, від 0.139 до 0.252 для LLR.
Величина ефектів (таблиця 5). Автори перераховують значущі результати у зміну показника при зростанні обсягу на одне стандартне відхилення:
| Пара | Чий обсяг | Кореляція, абс. | Кореляція, відн. | LLR, абс. | LLR, відн. |
|---|---|---|---|---|---|
| Індекс – IVV | лідера | −0.0477 | −24.57 % | +0.1453 | +14.45 % |
| Індекс – IVV | відстаючого | +0.0545 | +28.03 % | −0.0267 | −2.66 % |
| IVV – SPY | лідера | +0.0429 | +18.08 % | +0.0395 | +3.84 % |
| IVV – SPY | відстаючого | −0.0553 | −23.35 % | −0.0800 | −7.78 % |
Як читати відносні числа. Їх наведено у відсотках від загального рівня з таблиці 3. Для LLR цей рівень близько 1.0, а сама асиметрія, перевищення над одиницею, становить 0.006–0.028. Тому зсув LLR на 0.1453 в окремий день набагато більший за всю асиметрію за вибіркою: від дня до дня лідерство гуляє значно сильніше, ніж видно за річним числом (наш коментар).
Автори роблять висновок, що відстаючі в усіх парах сильніше впливають на кореляцію, ніж лідери, а на LLR найсильніше впливає обсяг індексу. І окремий висновок: блоковий обсяг впливає значущіше за неблоковий, тобто досвідчені учасники сильніше визначають випередження.
7. Торгова перевірка
Розділ 5.1 після рисунка 5 містить одну фразу про торгівлю. Автори застосували стратегію Alsayed і McGroarty (2014), торгувати відстаючого в напрямку попередньої зміни ціни лідера: "However, the strategy is not profitable, which is consistent with Brooks et al. (2001), who find that although the lead-lag effect can be used to produce accurate forecasts, trading these forecasts does not yield favourable returns."
Що з цього можна і чого не можна винести. Можна: найпростіша стратегія на випередженні 10–30 мс у цих інструментів, за словами авторів, грошей не дала. Не можна: чому саме. У роботі немає ні дохідності, ні кількості угод, ні врахування витрат, ні затримки виконання, ні періоду перевірки. Тому невідомо, чи з'їли результат комісії, спред, чи те, що 10 мс менше за реальну затримку надсилання ордера.
8. Що в роботі хитке
Застереження самих авторів
Формулювання обережні. В анотації лідерство "may strengthen or weaken depending on whether the leading or lagging instrument responds to that information", і вплив на кореляцію теж "may also have opposite effects". Першість заявлено із застереженням "To our knowledge".
Обсяг лише замінник інформації. Автори спираються на літературу, де обсяг використовують як замінник швидкості надходження інформації, а блокові угоди як замінник інституційних учасників. Прямої перевірки, що несподіваний обсяг пов'язаний з новинами, у роботі немає.
Що видно під час читання
Торгова перевірка без чисел. Див. розділ 7. Це єдине місце роботи, яке стосується грошей, і воно не перевірюване.
Очікуваний обсяг дорівнює вчорашньому. Це найпростіша модель очікування. Регулярні сплески обсягу (експірації, ребалансування індексу, кінець місяця, понеділки) потраплять у «несподіваний» обсяг і виглядатимуть як надходження інформації.
Обсяг індексу не описано. В індексу немає власних угод, а в таблиці 2 у нього 525 млн акцій на день і в регресіях є блоковий і неблоковий обсяг індексу. Як ці числа отримано (за компонентами індексу чи інакше) і що вважається блоковою угодою для індексу, у роботі не сказано.
Значущість помірна, спостережень небагато. Регресії денні на одному році даних (близько 250 торгових днів; точної кількості днів у роботі немає), з 8 або 12 змінними. Більшість значущих коефіцієнтів при обсязі на рівні 5 або 10 %; на 1 % значущі три коефіцієнти в панелі LLR. Поправки на те, що перевіряється багато коефіцієнтів у дев'яти регресіях, немає.
Обсяг і випередження одного дня. Обсяг і показники випередження беруться за той самий день. Регресія показує зв'язок, але не каже, що обсяг спричиняє зміну лідерства, а не навпаки. Це обмеження дизайну, а не помилка; автори формулюють висновок як вплив.
Напрямок ефекту на кореляцію не однаковий за парами. У парі індекс–IVV обсяг лідера знижує кореляцію, у парі IVV–SPY підвищує. Автори це зазначають, але не пояснюють.
Сітка 10 мс груба для таких затримок. Час випередження 10 мс у пари індекс–IVV це перший крок сітки, а в пари IVV–SPY кореляції за +10 і +20 мс майже рівні. Швидших ефектів метод не розрізнить.
Менш ліквідний фонд випереджає ліквідніший. У IVV у 15 разів менше спостережень і майже в 40 разів менший обсяг, ніж у SPY, але за таблицею 3 він випереджає SPY на 20 мс. У роботі це не обговорюється. Наше зауваження.
Два рисунки з номером 5. В авторській версії схему для пояснення LLR (сторінка 12) і реальні криві кореляції (сторінка 17) обидві підписано як рисунок 5. На висновки не впливає, але під час посилань на рисунки варто вказувати сторінку.
Період даних старий. Серпень 2014 – липень 2015 року. Інфраструктура ринків відтоді змінювалася, і абсолютні затримки, найімовірніше, теж.
9. Що з цього випливає на практиці
Кореляцію несинхронних рядів рахувати за проміжками, що перетинаються. Оцінка Hayashi–Yoshida не потребує вирівнювання за сіткою і не вигадує точок. Це підходить для будь-якої пари з власним ритмом угод: різні біржі, спот і ф'ючерс, фонд і його кошик.
Випередження описувати трьома числами. Положення піку, його висота і LLR за всією кривою. Пік в один бік при LLR в інший означає, що «лідер» веде лише на вузькому відрізку зсувів.
Кореляція без частоти замірів не число. 99.9 % на днях і близько 20 % на тиках для однієї і тієї самої пари. Рішення, ухвалені за денними кореляціями, не переносяться на внутрішньоденні масштаби.
Затримку випередження порівнювати зі своєю затримкою до будь-яких бектестів. Якщо лідер випереджає на 10–30 мс, а шлях від отримання даних до потрапляння ордера на біржу довший, стратегія закрита. За роботою час випередження не залежить від денного обсягу, тому його розумно вимірювати окремо і переглядати при змінах інфраструктури (наш висновок із панелі B).
Сила лідерства змінюється від дня до дня. У дні, коли незвично багато торгує відстаючий інструмент, лідерство слабше. Це перевірювана гіпотеза для фільтра сигналу, але в роботі її підтверджено на одному році даних і на рівнях значущості 1–5 %.
Статистична розрізненність не прибуток. LLR 1.02 відрізняється від одиниці на мільйонах спостережень, і найпростіша стратегія на ньому, за словами авторів, неприбуткова.
10. Тестовані ідеї
| № | Ідея | Тип | Де рахувати |
|---|---|---|---|
| 1 | Реалізувати кореляцію Hayashi–Yoshida за проміжками, що перетинаються, і порівняти з кореляцією за вирівняними барами на своїх парах з несинхронними угодами | діагностика | Python |
| 2 | Будувати криву кореляції за зсувом (наприклад, від −500 до +500 мс) для своїх пар майданчиків або інструментів і звітувати три числа: пік, його положення і LLR | діагностика | Python |
| 3 | Порівняти виміряний час випередження зі своєю затримкою від отримання даних до потрапляння ордера на біржу; якщо своя більша, ідею закрити до бектесту | метрика приймання | будь-яка |
| 4 | Звітувати LLR поруч із положенням піку і окремо позначати пари, де пік і LLR вказують у різні боки | аудит | Python |
| 5 | Побудувати кореляцію пари як функцію частоти замірів (тик, 1 с, 10 с, 1 хв, 5 хв, година, день), щоб побачити, з якого масштабу кореляційні оцінки взагалі застосовні | діагностика | Python |
| 6 | Рахувати LLR і час випередження за кожним днем і перевірити, чи слабшає лідерство в дні з аномальним обсягом відстаючого, як у парі IVV–SPY | діагностика | Python |
| 7 | Замінити «очікуваний обсяг = вчорашній» на середнє за 20 днів з поправкою на день тижня й експірації і перевірити, чи зберігаються ефекти обсягу | аудит | Python |
| 8 | Розділити потік на великі й дрібні угоди і перевірити, яка частина сильніше пов'язана із силою лідерства | діагностика | Python |
| 9 | Повторити найпростішу стратегію «торгувати відстаючого в бік останнього руху лідера» з явними витратами і затримкою виконання, щоб отримати числа, яких немає в роботі | метрика приймання | бектестер |