Як читати цей розбір. Це не робота про ринки, а дисертація із системного програмування. Трейдерові вона потрібна з однієї причини: торгова система зобов'язана записувати, що вона бачила і що зробила, інакше розбір живої сесії неможливий, а запис у журнал у гарячому шляху може коштувати дорожче за саме рішення. Робота показує, як зробити запис майже безкоштовним і чим за це платять. Головний висновок у розділі «Метод в один рядок». Найбільш переносне в торговий код зібрано в розділі 4 про будову буфера: ці прийоми годяться для будь-якої черги між потоками, від ринкових даних до стратегії і від стратегії до виконання. Глави про метапрограмування C++17 і про стиснення (4, 6, 8) переказано коротко, їх можна пропустити.
1. Навіщо трейдерові робота про журналювання
Журнал (лог) це рядки на кшталт «час, файл, рядок коду, рівень, повідомлення», які програма пише під час роботи. За ними потім відновлюють, що сталося: чому ордер пішов із запізненням, чому стратегія не увійшла, де система отримала стару котировку. Що більше подій записано, то кориснішим є журнал.
Автор починає з того, що журнал став дорогим відносно самих програм. Форматування одного рядка в типовій системі займає 0.5–1 мкс, це 1000–2000 тактів процесора. Одне повідомлення важить 50–100 байтів, тому диск на 250 МБ/с приймає лише кілька мільйонів повідомлень за секунду. Для серверів, які відповідають за 1–2 мкс, один рядок журналу може подвоїти час відповіді. Автор пише, що в Google і VMware на рев'ю коду сперечаються, залишити рядок журналу чи прибрати заради швидкості, і підсумовує: "Logging itself is expensive, but lacking proper logging is very expensive." (глава 1).
Для торгової системи ситуація та сама, тільки масштаб жорсткіший: якщо сигнал живе десятки мілісекунд, а запис «надіслав ордер» коштує мікросекунду в гарячому шляху, журналювання починає конкурувати із самим рішенням. Звичайний вихід, яким користуються і програмісти поза торгівлею, це писати менше: піднімати поріг важливості, вибірково пропускати повідомлення, вичищати «зайві» рядки. Автор зазначає, що всі ці прийоми купують швидкість ціною видимості.
2. Метод в один рядок
У гарячому шляху записувати в пам'ять лише те, що змінюється від виклику до виклику (мітку часу, номер повідомлення, значення аргументів), у двійковому вигляді; усе незмінне записати у файл один раз; текст для людини збирати окремою програмою після роботи.
Ідея тримається на двох спостереженнях автора (розділ 2.3). Перше: більшість повідомлень людина ніколи не читає, їх споживають інші програми, а людина дивиться малу частку журналу під час налагодження. Друге: у рядку на кшталт Creating table 'orders' with id 11 змінюються лише час, номер потоку, ім'я таблиці й число 11. Ім'я файлу, номер рядка, рівень і шаблон повідомлення відомі під час компіляції і повторюються в кожному виклику.
Звідси три частини системи (рисунок 3.1 роботи):
- на етапі компіляції окремий компонент знаходить усі виклики журналу, виймає з них сталу частину в словник і генерує для кожного виклику власну функцію запису
record()і функцію стисненняcompress(), без розбору рядка формату під час роботи; - під час роботи потік копіює мітку часу, номер повідомлення й аргументи у свій буфер у пам'яті і відразу повертається; фоновий потік забирає дані, стискає і пише на диск;
- після роботи окрема програма поєднує словник із двійковими записами і друкує звичайний текст або віддає записи програмі аналізу без перетворення на текст.
Мітку часу система бере просто з лічильника тактів процесора (Intel TSC) і не переводить у години й хвилини під час роботи: відповідність лічильника і настінного часу записано в заголовку файлу, переведення робить програма постобробки (розділ 5.3).
3. Де виграються наносекунди
Автор називає чотири прийоми, на яких тримається швидкість (розділ 3.1 і глава 12).
Відкладене форматування. Найдорожчий крок прибрано з роботи цілком: рядок формату не розбирається, числа в текст не перетворюються.
Розділення сталого і змінного. Стала частина записується у файл один раз, далі на кожен виклик пишуться лише номер повідомлення й аргументи. Для повністю сталого повідомлення це 3–4 байти замість 41–90 байтів в інших систем (розділ 9.1.3).
Заздалегідь згенерована логіка. Розбір рядка формату під час роботи потребує багатьох розгалужень, а вони погано уживаються з позачерговим виконанням і передбаченням переходів у процесорі. Функції, згенеровані під кожен виклик, виконуються прямим кодом майже без розгалужень.
Легке стиснення. Після видалення сталої частини в журналі залишаються переважно цілі числа, до того ж малі: номер повідомлення зазвичай уміщується в 1–2 байти, хоча під нього відведено 4, різниця міток часу менше 15 мс уміщується в 3 байти з 8. Тому замість словникових алгоритмів на кшталт gzip автор відкидає старші нульові байти і пише коротку ознаку довжини (глава 8). Рядки й дробові числа так не стискаються.
Що таке гарячий шлях. Ділянка коду, яка виконується на кожну подію і від швидкості якої залежить час реакції системи. У торговій системі це шлях від надходження ринкових даних до надсилання ордера. Усе, що можна зробити потім або в іншому потоці, з гарячого шляху виноситься.
4. Проміжний буфер: глава 7 за кроками
Глава 7 найкорисніша для будь-кого, хто пише багатопотоковий торговий код. Автор починає з найпростішого рішення і покращує його крок за кроком, від затримок у мікро- і мілісекунди до одиниць наносекунд.
Крок 0: спільна черга з блокуванням. Усі потоки пишуть в одну чергу, захищену одним блокуванням (mutex). Плюс один: порядок повідомлень виходить сам собою. Мінусів три. Усі потоки шикуються в чергу один за одним. Фоновий потік не може читати, поки хтось пише. І саме блокування дороге: запис у NanoLog займає близько семи наносекунд, а "a lock operation can take several times longer as it requires explicit and excessive cache synchronization" (розділ 7.2). Гірше того, деякі реалізації блокувань присипляють потік, що чекає, і тоді операція на наносекунди розтягується на мілісекунди, поки операційна система не поверне потік до роботи.
Крок 1: власний буфер у кожного потоку. Потоки, які пишуть журнал, перестають зустрічатися один з одним. Платять за це двома речами: виділенням пам'яті під час створення потоку (не більше одного разу на потік) і втратою спільного порядку. Усередині одного буфера повідомлення впорядковані за часом, між буферами ні. Сортування переноситься в постобробку. Виділення пам'яті можна зробити заздалегідь окремим викликом, щоб воно не збіглося з критичною за часом ділянкою.
Крок 2: без блокувань, у кожної змінної один записувач. Буфер це кільце з двома позначками: producerPos, куди пише потік застосунку, і consumerPos, звідки читає фоновий потік. Першу змінює лише потік, що пише, другу лише фоновий, читати обидві може кожен.
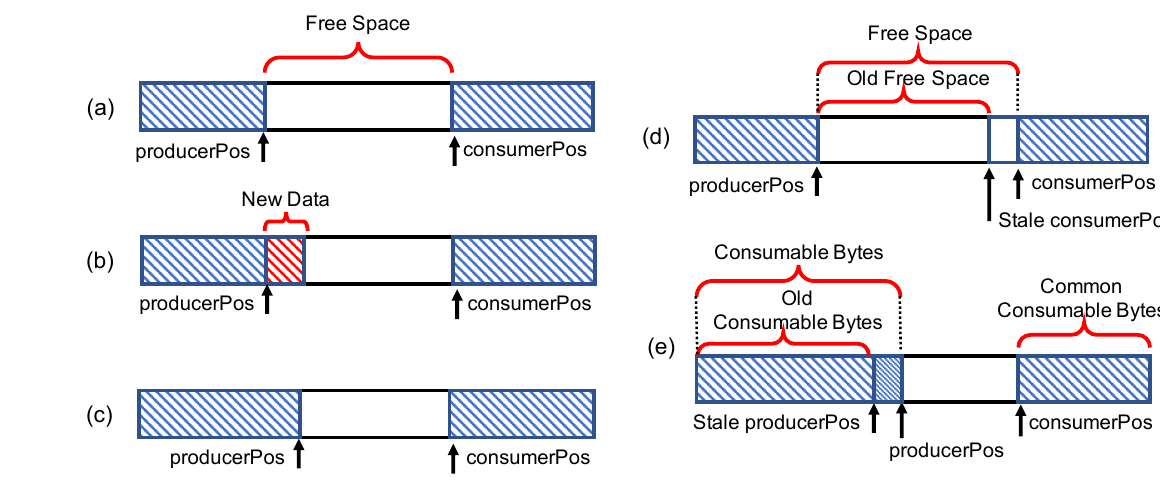
Як його читати. Заштриховані ділянки зайняті даними, білі вільні. Частини (a)–(c) показують запис: (a) вільне місце рахується як різниця між позицією читача і позицією записувача; (b) якщо місця вистачає, нові дані копіюються в позицію записувача; (c) позиція записувача зсувається за нові дані.
Що треба побачити. Частини (d) і (e) пояснюють, чому блокування не потрібне. У (d) записувач користується застарілим значенням позиції читача (
Stale consumerPos). Читач за цей час міг просунутися і звільнити ще місце, тому «старе вільне місце» (Old Free Space) завжди менше за справжнє і цілком у ньому лежить. У (e) те саме з іншого боку: читач за застарілою позицією записувача бачить менше готових даних, ніж їх є.Практичний висновок. Якщо помилка від застарілого значення завжди в обережний бік, синхронізація не потрібна: у найгіршому разі потік даремно відмовиться писати або прочитає дані на наступному колі, але ніколи не затре непрочитане.
Автор формулює це так: вільне місце з часом може лише зростати, тому "using an old value would only at worse underestimate the free space" (розділ 7.4). Дві умови при цьому обов'язкові, і їх легко пропустити, якщо переносити прийом у свій код. Перша: порядок операцій з пам'яттю. Записувач спершу кладе дані і ставить бар'єр запису (store fence), і лише потім зсуває свою позицію; читач спершу дочитує дані з бар'єром читання (load fence), і лише потім зсуває свою. Друга: у виносці автор обумовлює припущення "Individual reads and writes to single-word values are assumed to be atomic." (розділ 7.4). Є і третя деталь: коли запис не вміщується в кінець кільця, записувач позначає кінець зайнятої ділянки окремим вказівником і переходить на початок; цей вказівник теж пишеться до зсуву позиції.
Якщо місця не вистачає, функція запису повертає помилку і повторює спробу. Інакше кажучи, при переповненні буфера потік, що пише, чекає. Це важлива деталь для торгової системи, до неї повернемося в розділі 6.
Крок 3: запам'ятовувати чужу позицію. Схема без блокувань усе ще дорога під навантаженням: щоб порахувати вільне місце, записувач на кожному записі читає позицію, яку щойно змінив інший потік на іншому ядрі. Таке читання промахується повз кеш, і "This cache miss can slow the operation by tens of nanoseconds" (розділ 7.5), тобто в кілька разів дорожче за сам запис. Якщо обидва потоки працюють у такт, промах трапляється на кожній операції.
Рішення: кожен потік тримає в себе лічильник вільного (або готового до читання) місця, віднімає від нього під час кожної операції і йде читати чужу позицію лише тоді, коли лічильник скінчився. Це безпечно з тієї самої причини, що й крок 2: запам'ятоване значення рівносильне навмисно «замороженій» застарілій позиції, а застаріла позиція ніколи не завищує вільне місце.
Як це працює на числах (наш приклад, у роботі чисел немає). Буфер 1 МБ, середній запис 100 байтів. Без запам'ятовування записувач читає позицію читача на кожному з 10 000 записів, які вміщуються в буфер: 10 000 дорогих читань. Із запам'ятовуванням він один раз дізнався, що вільно 500 КБ, і наступні приблизно 5 000 записів узагалі не торкається чужої пам'яті. Кількість дорогих звернень падає в тисячі разів, якщо читач встигає звільняти місце.
Крок 4: рознести змінні по різних лініях кешу. Навіть після кроку 3 лічильники записувача і читача можуть опинитися в одній лінії кешу. Тоді запис у свій лічильник вибиває з кешу сусідній лічильник іншого потоку, хоча логічно вони незалежні. Це і є хибне розділення (false sharing). NanoLog вставляє між змінними записувача і змінними читача порожній масив розміром у лінію кешу.
Що таке лінія кешу і хибне розділення. Процесор переносить пам'ять між ядрами не по байтах, а блоками фіксованої довжини, на поширених x86-процесорах це 64 байти (розмір наш, у роботі його не названо). Якщо ядро A змінило змінну, копія всього блоку в кеші ядра B вважається застарілою, і B під час наступного звернення йде по свіжу копію. Коли в одному блоці лежать дві незалежні змінні, які пишуть різні потоки, вони заважають одна одній без жодного логічного зв'язку. Під час читання коду цього не видно.
Крок 5: опитування замість сигналу. Класичний спосіб повідомити фоновий потік, що з'явилися дані, це умовна змінна (condition_variable::notify()). Автор її виміряв: "The notify operation takes on the order of 14 nanoseconds in my measurements" (розділ 7.7), удвічі більше за цільові 7 нс на весь запис. Тому потік застосунку нікому не сигналить, а фоновий потік сам обходить буфери по колу. Зворотний бік: між колами опитування фоновий потік спить, і це видно на хвості затримок (розділ 5).
Крок 6: службові дані всіх буферів поспіль. Спершу службові поля кожного буфера (позиції, лічильники, роздільники) лежали поруч із його сховищем, і службові поля сусідніх буферів опинялися в пам'яті на відстані розміру сховища. Попередня вибірка процесора не вгадувала наступну адресу. Коли службові поля всіх буферів зібрали в одну неперервну ділянку, опитування кожного буфера здешевшало приблизно на один промах кешу (розділ 7.8).
Підсумок глави словами автора: буфери працюють "in the range of single digit nanoseconds vs. the micro- to milliseconds incurred by a centralized, monitor-style queue" (розділ 7.9).
5. Що показали заміри
Стенд (таблиця 9.1): чотириядерний Xeon X3470 на 2.93 ГГц, 24 ГБ пам'яті, SSD Samsung 850 PRO з виміряною швидкістю близько 250 МБ/с на великих записах, Debian 8.3 з ядром Linux 3.16.7. Порівнювалися Log4j2, spdlog, glog, Boost Log і Event Tracing for Windows (ETW) на шести повідомленнях з відкритого сховища RAMCloud: від повністю сталого рядка до рядка з довгим змінним текстом.
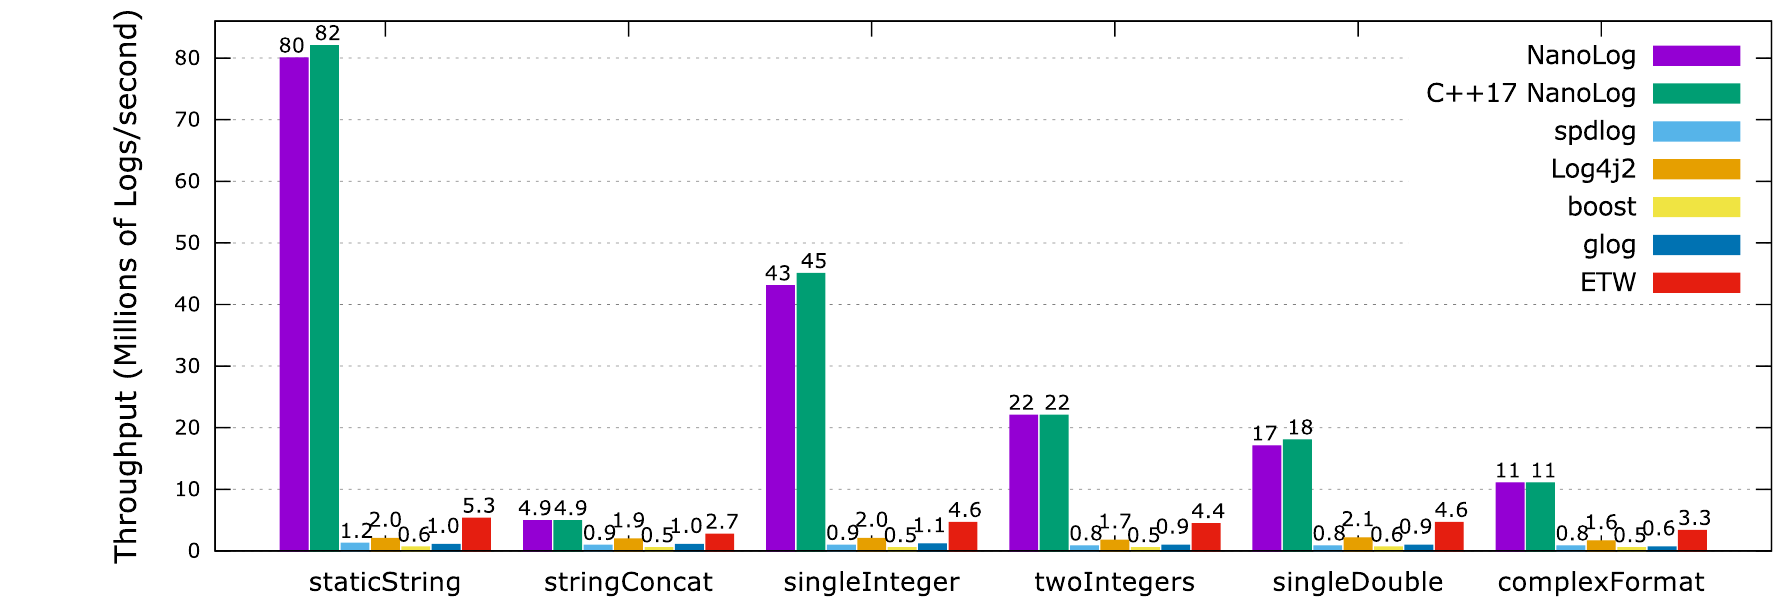
Як його читати. По горизонталі шість повідомлень бенчмарку, по вертикалі мільйони повідомлень за секунду. У кожній групі сім стовпчиків: дві версії NanoLog і п'ять інших систем. «NanoLog» тут версія з препроцесором, «C++17 NanoLog» версія на шаблонах C++17. Кількість потоків змінювалася від 1 до 16, показано найкращий результат; у всіх систем, крім Log4j2, у замір входить скидання на диск.
Що треба побачити. На сталому рядку (staticString) NanoLog видає 80–82 млн повідомлень за секунду проти 0.6–5.3 млн в інших. На рядку з довгим змінним текстом (stringConcat) розрив майже зникає: 4.9 млн проти 0.5–2.7 млн. NanoLog не стискає рядки і пише їх цілком, тому що більше в повідомленні тексту, то менша його перевага.
Практичний висновок. Виграш NanoLog це виграш у байтах на повідомлення. Журнал торгової системи, де в повідомленнях переважно числа (ціни, обсяги, ідентифікатори), ближчий до правої половини графіка, до повідомлень із цілими і дробовими числами, де NanoLog видає 11–45 млн.
За затримкою одного виклику (таблиця 9.4: один потік, 100 000 викликів поспіль з паузою 600 нс між ними) медіана NanoLog 7–8 нс, а 99.9-й перцентиль від 27 до 37 нс. У ETW медіана 180–242 нс, у Log4j2 146–230 нс, у spdlog 230–1234 нс, у glog 1201–2570 нс, у Boost 1619–4175 нс. Автор зводить це так: затримка виклику в NanoLog у 18–500 разів нижча, ніж в інших систем.
Вбудовування у справжній застосунок. Автор вбудував NanoLog і spdlog у сховище «ключ–значення» RAMCloud, увімкнув усі докладні повідомлення і додав постійні заміри продуктивності, разом 11–33 виклики журналу на запит читання або запису (таблиця 9.6). З NanoLog медіанна затримка читання зросла на 3 %, запису на 3–4 %, пропускна здатність запису впала на 2 %, читання на 19 % (потік диспетчеризації RAMCloud і без того вузьке місце на читанні). Зі spdlog затримки зросли в 1.6 раза, пропускна здатність читання впала до 12 % початкової, з вбудованим журналом RAMCloud до 7 %.
З цих чисел автор оцінює ціну одного виклику в реальній роботі:
Що це таке. Ціна одного виклику журналу всередині справжнього застосунку, а не в мікротесті.
Що означає кожне число. 5.33 мкс: медіанна затримка читання в RAMCloud із журналом NanoLog. 5.19 мкс: вона ж без журналу. 8: скільки з увімкнених повідомлень лежить на критичному шляху одного читання.
Рахунок за кроками. Відняти один час від іншого: 0.14 мкс додав журнал. Поділити на 8 викликів: 0.0175 мкс на виклик, тобто 17.5 нс. Для запису (27 викликів на критичному шляху) автор отримує 17.7 нс.
Навіщо це потрібно. Це у 2–2.5 раза більше за 7–8 нс із мікротесту. Автор припускає, що різниця від промахів кешу на буферах, і прямо пише, що перевірити це глибше не зміг. Для spdlog такий самий розрахунок дає близько 380 нс, близько до мікротесту.
Збирання RAMCloud з версією на препроцесорі стало довшим на 17 %, бінарник більшим на 16 %; з версією C++17 збирання довше на 2 %, бінарник більший на 19 %.
Де вузьке місце. Рисунок 9.5 показує, що саме обмежує пропускну здатність.
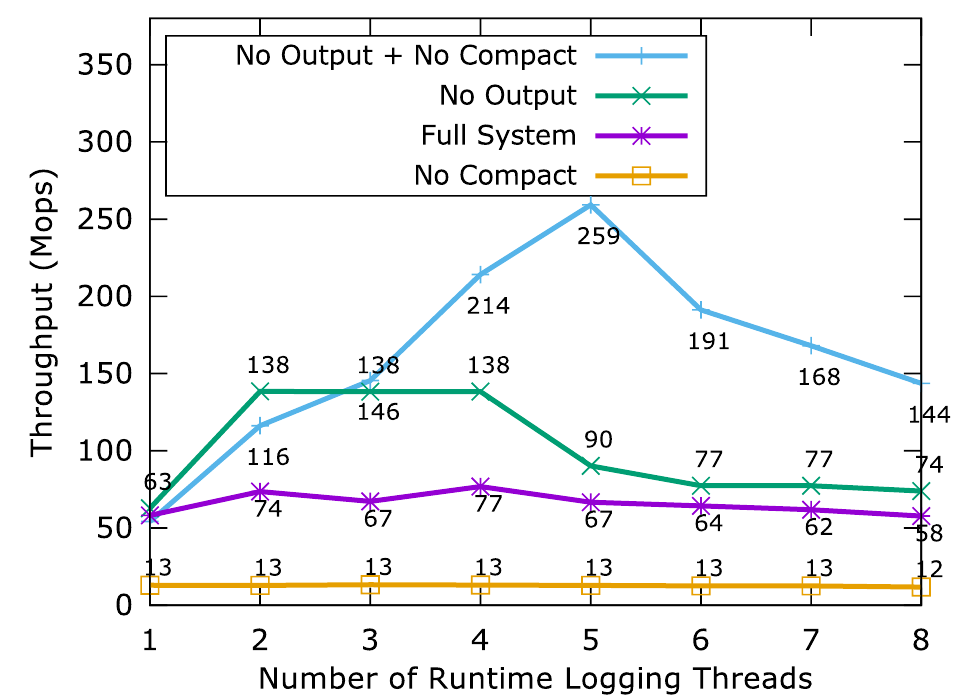
Як його читати. По горизонталі кількість потоків, які пишуть журнал (від 1 до 8), по вертикалі мільйони повідомлень за секунду. Full System це звичайна робота. No Output надсилає журнал у
/dev/null, тобто прибирає диск. No Compact вимикає стиснення. No Output + No Compact прибирає і те, і інше.Що треба побачити. Без стиснення пропускна здатність падає до 13 млн: повідомлення важить близько 16 байтів замість 3–4, і диск не встигає. Без диска вона піднімається до 138 млн, і вузьким місцем стає вже стиснення. Без того й іншого до 259 млн за п'яти потоків, далі падає: у машини 4 фізичні ядра, і потоки застосунку починають відбирати процесор у фонового потоку.
Практичний висновок. На звичайному залізі межу задає обсяг байтів на диск, а не код запису. Звідси цінність стиснення в гарячому шляху, яке на перший погляд здається зайвою роботою.
Автор показує, чому стиснення не можна просто викинути при швидшому диску:
Рахунок за кроками. 138 млн повідомлень за секунду (стільки видає система без диска) помножити на 16 байтів нестисненого повідомлення: близько 2.2 млрд байтів за секунду. Такий диск потрібен, щоб без стиснення тримати ту саму швидкість, а не диск удвічі швидший за стендовий.
Хвіст затримки і розмір буфера. Рисунок 9.6 потрібен тому, хто думає про найгірший випадок, а не про медіану.
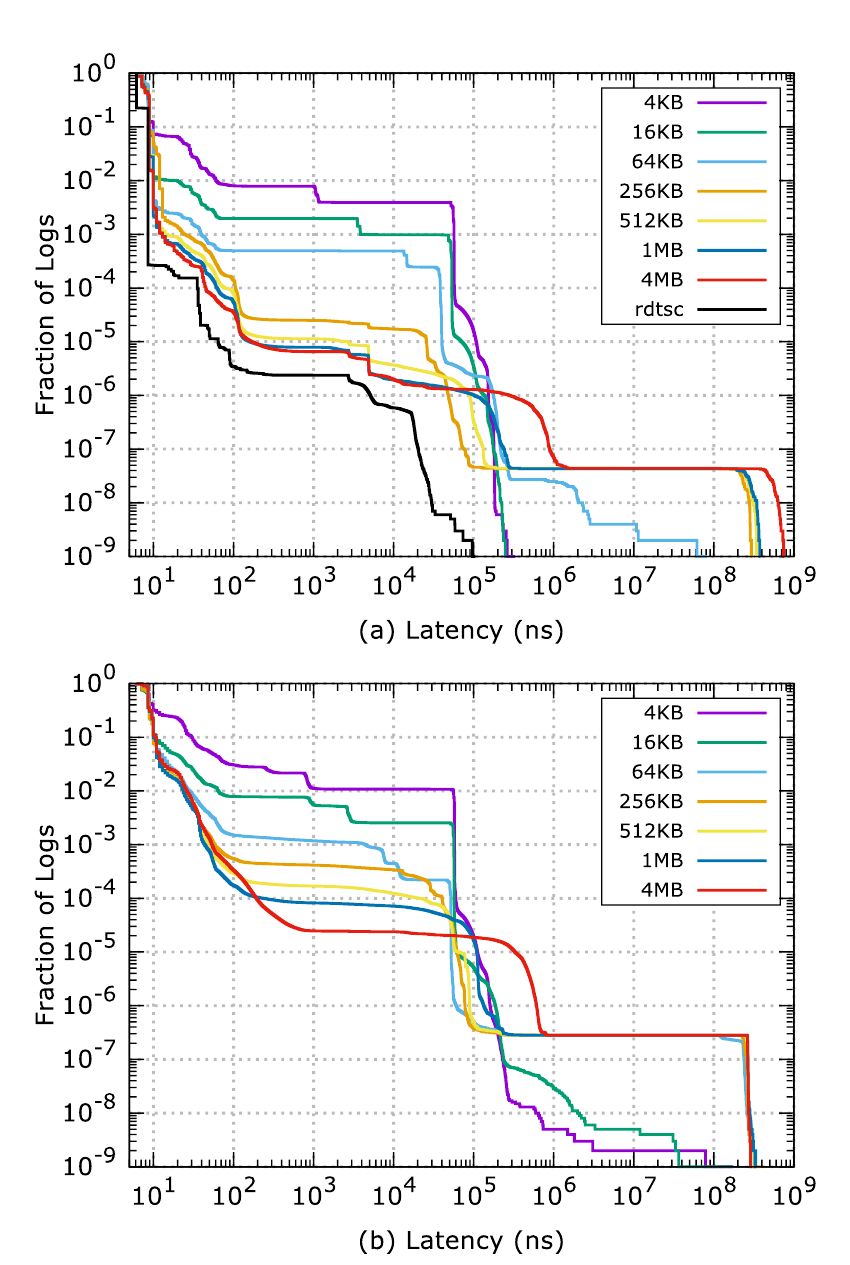
Як його читати. Це додаткова функція розподілу (CCDF): точка (x, y) означає, що частка y усіх викликів зайняла не менше x наносекунд. Обидві осі логарифмічні. Верхня панель для сталого рядка, нижня для складного повідомлення. На кожній кривій мільярд викликів поспіль без пауз одним потоком, тобто журнал свідомо пишеться швидше, ніж встигає диск. Чорна лінія rdtsc на верхній панелі: мільярд читань лічильника тактів поспіль, нижня межа того, що взагалі можливо на цій машині.
Що треба побачити. Незалежно від розміру буфера 90 % викликів швидші за 10 нс. Що більший буфер, то більша частка швидких викликів: при 4 КБ близько 90 %, при 512 КБ 99.8 %; далі 512 КБ виграш майже не зростає. Потім два щаблі. Близько 50 мкс: фоновий потік спить між колами опитування, і малий буфер встигає заповнитися. Близько 100+ мс: заповнився вихідний буфер на 64 МБ, і всі чекають диска.
Несподіваний наслідок. Найповільніший запис гірший у великого буфера. При 4 КБ найгірший виклик займає десятки мікросекунд, при 4 МБ сотні мілісекунд. Автор пояснює: малий буфер часто і коротко гальмує потік, що пише, і диск встигає; великий накопичує більше і потім чекає диска довше. За його словами,
"the more frequent the stalls, the better the worst-case performance"(розділ 9.6).
За замовчуванням NanoLog ставить буфер 1 МБ, після якого частка швидких викликів майже не зростає. Автор одразу обумовлює, що дослід штучний: застосунок лише пише журнал і нічого не робить між викликами. За розумного темпу, наприклад одне повідомлення на 1000 нс, він очікує хвіст помітно кращий і ближчий до лінії rdtsc, але й тоді можливі затримки близько 100 мкс з причин поза застосунком.
Решта глави 9 коротко. Програма постобробки однопотокова і перетворює на текст близько 0.5 млн повідомлень за секунду; майже весь час іде на форматування дати й контексту, близько 2 мкс на повідомлення. Сортування 4096 потоків знижує її швидкість приблизно на 10 %. Агрегація (мінімум, середнє, максимум за одним повідомленням) просто по двійковому журналу коштує 35–44 нс на повідомлення проти 350+ нс у C++, awk і Python по текстовому журналу; двійковий файл важив близько 747 МБ проти 7.6 ГБ тексту, і різниця майже цілком пояснюється обсягом читання з диска.
6. Що в роботі хитке
Застереження самого автора
Мікротести описують найкращий випадок. Про таблицю затримок автор пише, що результати "may represent an unrealistic, best-case performance for all logging systems" (розділ 9.1.4): застосунок у тесті лише пише журнал, нічим не забруднює кеш і не змагається за диск і процесор. Вбудовування в RAMCloud це підтверджує: 17.5 нс замість 7–8.
Дослід із хвостом затримки штучний. "this benchmark is a bit unrealistic/contrived" (розділ 9.6). Він показує поведінку при переповненні, а не за звичайного навантаження.
При переповненні потік, що пише, чекає. NanoLog гарантує, що жодне повідомлення не загубиться, і платить за це блокуванням: "NanoLog can block, but will never miss any critical events" (розділ 11.5). Системи трасування на кшталт KUTrace чинять навпаки: перезаписують старі події і ніколи не гальмують застосунок. Автор прямо визнає, що розкид затримки в NanoLog через це більший, ніж у них, і описує, як наблизити NanoLog до трасувальника: вимкнути фоновий потік, скидати на диск після вікна спостереження, збільшити буфер, обмежити кількість аргументів.
Порядок подій відновлюється потім, і є рідкісний випадок, коли це може не спрацювати. Постобробка тримає два раунди виведення і зливає їх за мітками часу. Якщо потік прочитав лічильник тактів, був витіснений планувальником і не дописав аргументи довше за два раунди, його повідомлення опиниться у файлі пізніше за пізніші. Автор поставив на цей випадок перевірку і пише, що вона жодного разу не спрацювала, хоча на 4–8 ядрах крутилися тисячі потоків; у версії на GitHub про всяк випадок тримається три раунди (розділ 6.1.4).
Чотири принципові обмеження (розділ 10.2). Система додає в збирання окремий крок і окрему програму постобробки, тобто нові точки відмови. Якщо журнал усе одно потрібен людині у вигляді тексту, у сумі ресурсів іде більше, ніж у звичайної бібліотеки, і автор формулює умову застосовності: "NanoLog only makes sense in situations where runtime performance is paramount". Працює лише стиль printf зі сталим рядком формату; динамічні рядки формату і виведення структур даних не підтримуються. І нарешті, "NanoLog is not a silver bullet to application visibility": що і де журналювати, як і раніше, вирішує розробник, а зайві повідомлення ускладнюють розбір.
Пояснення, яких автор не перевіряв. Чому ETW повільніший за схожої конструкції (ETW закритий, заміряти глибше не вдалося), чому виклик у RAMCloud дорожчий за мікротест, чому виграш від буфера перестає зростати після 512 КБ, чому стиснення іноді швидше за просте копіювання пам'яті. Скрізь стоїть «I suspect» або пряме «не перевіряв».
Майбутнє системи. У висновку автор не чекає, що прототип стане стандартом: "I don't envision that the NanoLog system will become a staple of logging anytime soon" (розділ 12.1). Він розраховує на перенесення прийомів в інші системи.
Що видно під час читання
Усі заміри зроблено автором на власній системі. Конкурентів налаштовано за описом автора (spdlog з буфером на 8192 записи, glog з буфером на 30 секунд, Log4j2 з асинхронними логерами і LMAX Disruptor), незалежного повторення в роботі немає. spdlog обрано, за словами автора, як перший результат пошуку «Fast C++ Logger». Це не робить порівняння нечесним, але означає, що конкурентів можна було налаштувати й інакше.
Залізо старе для 2020 року. Чотириядерний Xeon і SATA SSD на 250 МБ/с. Абсолютні числа на сучасному сервері з NVMe-диском будуть іншими; автор сам показує (рисунок 9.5), що за швидшого диска вузьким місцем стає стиснення.
Різні числа в різних місцях описують різні повідомлення, а не суперечність. В анотації "typical log invocation overhead of 8 nanoseconds" і до 82 млн повідомлень за секунду, у розділі «Industrial Response To NanoLog» перед змістом "median invocation latency of 7-19 nanoseconds", у главі 1 близько 80 млн. 82 млн це версія C++17 на сталому рядку, 80 млн версія з препроцесором. Читачеві варто брати числа з таблиці 9.4 і рисунка 9.2 разом із типом повідомлення.
Перенесення в Python безпосередньо неможливе. Це наше зауваження, не автора: прийоми глави 7 спираються на модель пам'яті C++ і на бар'єри, яких в інтерпретатора з глобальним блокуванням немає в тому самому вигляді. Застосовні вони до частин системи на C++ або Rust.
7. Що з цього випливає на практиці
Журналювати в гарячому шляху можна, якщо не форматувати. Писати двійковий запис мінімального обсягу з міткою з лічильника тактів, перетворювати його на текст іншим процесом, на іншому ядрі або іншій машині. Це знімає вибір між «писати журнал» і «бути швидким», який автор вважає хибним.
Правило одного записувача замість блокування. Для будь-якої спільної структури перевірити дві речі: у кожної змінної рівно один потік, який її пише, і застаріле значення помиляється в безпечний бік. Якщо обидві умови виконано, блокування можна зняти, але лише разом із правильними бар'єрами пам'яті.
Не читати чужу змінну на кожній ітерації. Запам'ятати останнє значення і перечитувати, коли запас скінчився. Це дешева зміна з ефектом на кількості промахів кешу.
Перевіряти розміщення полів у структурах, яких торкаються різні потоки. Хибне розділення не видно в коді, і його не ловить профайлер, який показує час за функціями.
Вирішити заздалегідь, що робити при переповненні. Чекати (як NanoLog) означає ризикувати затримкою ордера на сотні мілісекунд у найгіршому разі; викидати (як трасувальники) означає втрачати події в найцікавіший момент. Розмір буфера зсуває цей вибір: великий буфер робить рідкісні затримки довшими, малий робить їх частішими і коротшими.
Міряти хвіст, а не середнє. Медіана 7 нс нічого не каже про виклик на сто мілісекунд раз на мільярд. Графік на кшталт рисунка 9.6 показує це відразу.
Порядок подій це проєктне рішення з ціною. Буфер на потік швидший за спільну чергу, але потребує міток часу в кожному записі і сортування під час розбору. Для журналу, за яким відновлюють послідовність торгових рішень, це треба вирішити явно.
8. Тестовані ідеї
| № | Ідея | Тип | Де рахувати |
|---|---|---|---|
| 1 | Виміряти ціну одного виклику журналу в гарячому шляху своєї системи за медіаною і 99.9-м перцентилем, окремо в мікротесті і під реальним навантаженням (за прикладом розрахунку 17.5 нс з RAMCloud) | діагностика | будь-яка |
| 2 | Перевести журнал гарячого шляху на двійковий запис аргументів із форматуванням в окремому процесі і порівняти затримку від надходження даних до надсилання ордера до і після | зміна конструкції | будь-яка |
| 3 | Пройти всі міжпотокові структури: у кожної змінної один записувач, застаріле значення помиляється в безпечний бік, бар'єри пам'яті стоять до зсуву позиції | аудит | будь-яка |
| 4 | Замінити читання позиції іншого потоку на кожній ітерації запам'ятованим лічильником вільного місця і порівняти затримку під навантаженням | зміна конструкції | будь-яка |
| 5 | Перевірити розміщення полів у спільних структурах і рознести поля різних записувачів по різних лініях кешу; виміряти різницю | аудит | будь-яка |
| 6 | Звітувати затримку системи як додаткову функцію розподілу до рівня 10⁻⁶ і нижче, а не середнім | метрика приймання | Python |
| 7 | Прогнати сплеск подій швидший, ніж встигає диск, за різних розмірів буфера і вибрати розмір за найгіршим викликом, а не за медіаною | діагностика | будь-яка |
| 8 | Перевірити під час постобробки, що повідомлення різних потоків після злиття йдуть за неспадними мітками часу, і рахувати порушення | аудит | Python |
| 9 | Замінити сигнал фоновому потоку (умовна змінна) опитуванням і порівняти затримку запису і навантаження на ядро | зміна конструкції | будь-яка |