Как читать этот разбор. Работа отвечает на два вопроса: кто из индекса и двух ETF на него опережает и на сколько миллисекунд, и как это опережение меняется в дни, когда приходит новая информация. Метод измерения опережения, который пригодится для любой пары инструментов с несинхронными сделками, разобран в разделах 2 и 3 с формулами и числами. Результаты в разделах 5 и 6. Если нужен только практический вывод, читайте разделы 7, 8 и 9: торговая проверка в работе одна фраза, и об этом надо знать до того, как ссылаться на неё.
1. Как устроена задача
Опережение (lead-lag) это ситуация, когда один инструмент повторяет движения другого с задержкой. Если бы рынок был эффективным и без трений, у родственных инструментов, например индекса и фонда на этот индекс, доходности совпадали бы по времени. На практике опережение находят постоянно, особенно между фьючерсом и индексом. Обзор литературы в работе даёт ориентиры по старым исследованиям: фьючерс опережает индекс на время до 45 минут, индекс фьючерс не больше 15 минут; при этом Brooks и соавторы (2001) нашли, что точные прогнозы на опережении после учёта издержек не обгоняют эталон.
Авторы берут три инструмента на один и тот же индекс: сам S&P 500 и два самых ликвидных ETF на него, SPY (State Street) и IVV (BlackRock). Все три торгуются электронно и все спотовые, поэтому объяснения через разную стоимость торговли и разный механизм торгов (электронный или в зале), которыми литература объясняла опережение фьючерса, здесь, по мысли авторов, не работают. Остаётся скорость, с которой инструменты отражают новую информацию.
Измерять приходится на тиках, а не на барах. Авторы ссылаются на Huth и Abergel (2014): электронная торговля сократила задержку настолько, что данные с регулярной сеткой её больше не ловят. А на тиках возникает другая проблема: сделки по двум инструментам происходят в разные моменты, и выровнять их по сетке без искажений нельзя.
Что такое эффект Эппса. Наблюдение Epps (1979): чем чаще замеряют цены, тем ниже корреляция между инструментами, даже между почти одинаковыми. Индекс и фонд на него на дневных данных коррелируют на 99.9 %, а на тиках около 20 %. Причины в несинхронности сделок и в том, что на очень коротком масштабе общая информация ещё не успела дойти до обеих цен.
2. Метод в одну строку
Посчитать корреляцию двух тиковых рядов без выравнивания по сетке (перемножать доходности только на пересекающихся промежутках между сделками), затем сдвигать один ряд во времени с шагом 10 мс и искать сдвиг, при котором корреляция максимальна. Положение пика это время опережения, высота пика это корреляция опережения, асимметрия всей кривой это отношение опережения.
Методика взята у Alsayed и McGroarty (2014): корреляция по Hayashi и Yoshida (2005), её расширение на сдвиги по Hoffmann, Rosenbaum и Yoshida (2013), отношение опережения по Huth и Abergel (2014). Вклад работы не в методе, а в том, что эти три величины считаются по каждому дню и объясняются дневным объёмом.
3. Как считают опережение
3.1 Корреляция без выравнивания
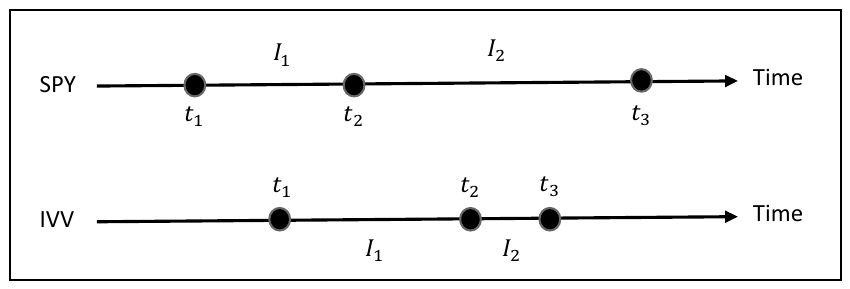
Как его читать. Две оси времени. Точки это моменты сделок, время прихода наблюдения, промежуток между двумя соседними сделками одного инструмента.
Что нужно увидеть. У SPY и IVV сделки идут в разные моменты, и промежутки разной длины. Взять «доходность за ту же секунду» у обоих нельзя: внутри секунды у одного может быть много сделок, у другого ни одной.
Что это такое. Ковариация по Hayashi и Yoshida: формула (1) работы.
Что означает каждый значок. («эр СПАЙ на промежутке и-катый»): доходность SPY между двумя его соседними сделками. : то же для IVV на его промежутке. : индикатор, равен 1, если промежутки хоть чуть-чуть пересекаются во времени, и 0, если нет. («пересечение»), («пустое множество»): запись читается «у промежутков есть общая часть».
Счёт по шагам. Перебрать все пары «промежуток SPY, промежуток IVV». Если пересекаются, перемножить доходности и прибавить к сумме. Если нет, пропустить. Никаких достроенных точек.
Пример по рисунку 2. Авторы перечисляют пересекающиеся пары: (, ), (, ) и (, ). Первый промежуток SPY короткий и задевает только первый промежуток IVV, второй длинный и задевает оба.
Что это такое. Формулы (2)–(4) работы: «стандартное отклонение» каждого ряда как корень из суммы квадратов его собственных доходностей и корреляция как ковариация, делённая на их произведение. Каждый ряд считается по своим промежуткам, без синхронизации.
Пример на числах (наш пример). Доходности SPY на двух промежутках +0.02 % и −0.01 %, IVV +0.03 % и −0.02 %, пересечения как на рисунке 2. Ковариация . Отклонения и . Корреляция .
Зачем это нужно. Это стандартный способ считать корреляцию пары с несинхронными сделками. Интерполяция и выравнивание по сетке, по словам авторов, вносят смещения, которых этот способ избегает.
3.2 Сдвиг и кривая корреляции
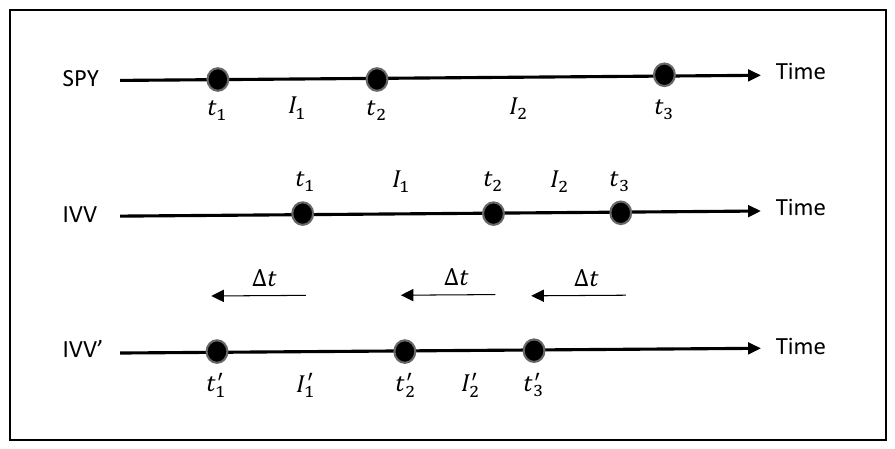
Как его читать. IVV' это копия ряда IVV, в которой каждое наблюдение сдвинуто назад по времени на одну и ту же величину . Затем корреляция пересчитывается между SPY и IVV'.
Что нужно увидеть. Если IVV повторяет за SPY с задержкой, сдвиг IVV назад выравнивает реакцию с причиной, и корреляция растёт. Сдвиг, при котором она наибольшая, и есть задержка.
Что это такое. Формула (5) работы: та же корреляция Hayashi–Yoshida, но со сдвинутым рядом. Штрих значит «после сдвига»; проверяет пересечение промежутков SPY с уже сдвинутыми промежутками IVV.
Как строится кривая. пересчитывается для от −100 до +100 мс с шагом 10 мс, всего 21 значение. В паре SPY–IVV сдвигается IVV, в парах с индексом сдвигается индекс, а ETF остаётся на месте.
Как читать результат. Пик при нуле: опережения нет. Пик при отрицательном сдвиге: сдвигаемый инструмент отстаёт на эту величину. Пик при положительном: опережает.
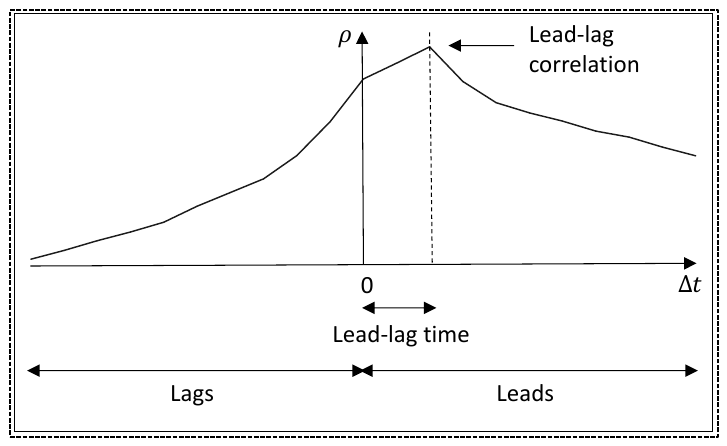
Как его читать. Высота пика называется корреляцией опережения (lead-lag correlation), его положение по горизонтали временем опережения (lead-lag time). Слева от нуля сторона отставания (lags), справа сторона опережения (leads).
3.3 Отношение опережения
Что это такое. Формула (6) работы, отношение опережения (lead-lag ratio) по Huth и Abergel: насколько кривая корреляции выше на стороне опережения, чем на стороне отставания.
Что означает каждый значок. В числителе сумма квадратов корреляций при всех положительных сдвигах (10 точек от +10 до +100 мс), в знаменателе при всех отрицательных (от −10 до −100 мс). Больше единицы: сдвигаемый инструмент чаще ведёт, чем следует.
Пример на числах (наш счёт). У пары индекс–IVV корреляции на кривой около 0.193–0.194. Десять квадратов на каждой стороне дают сумму около . LLR = 1.0058 из таблицы 3 означает, что сумма на стороне опережения больше суммы на стороне отставания всего на 0.58 %.
Зачем нужна третья величина. Пик описывает одну точку кривой. Авторы показывают отдельной схемой случай, когда пик стоит на стороне опережения, а вся кривая выше на стороне отставания.
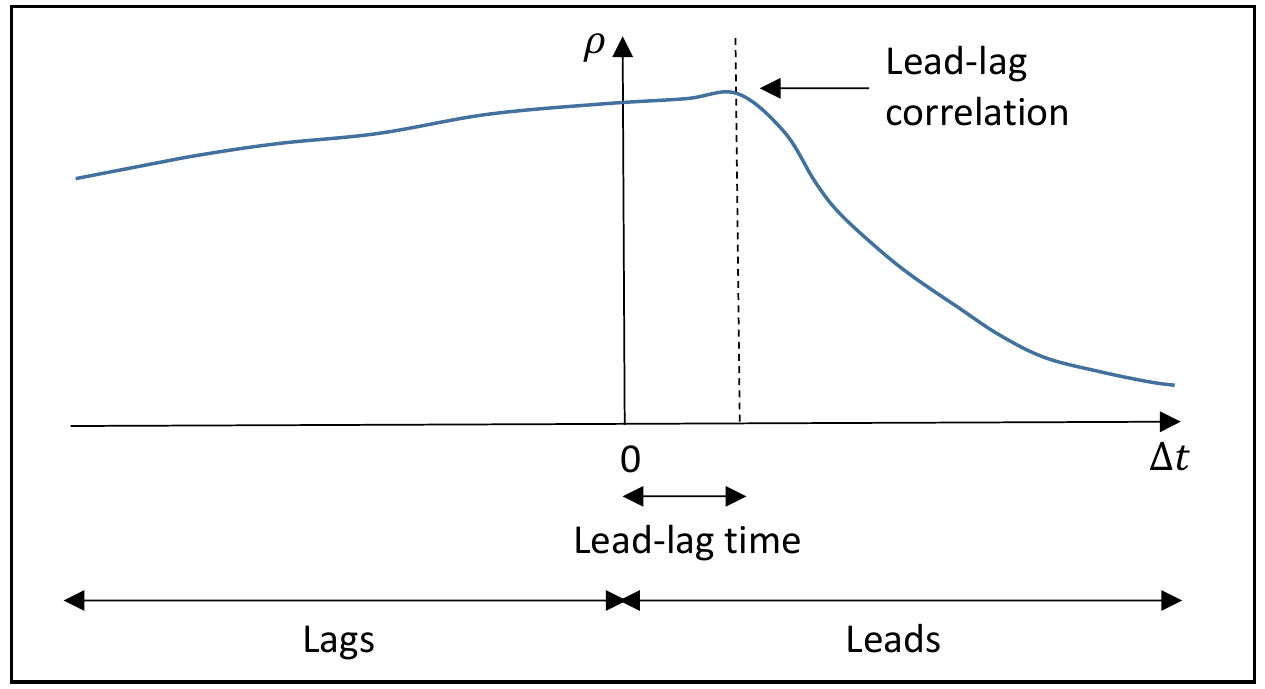
Как его читать. Пик кривой стоит справа от нуля, на стороне опережения, поэтому по пику сдвигаемый инструмент ведёт. Но слева кривая почти везде выше, чем справа после пика, и LLR будет меньше единицы: по всей кривой этот инструмент скорее отстаёт.
Практический вывод. Отчитывать надо обе величины. Пик и отношение опережения могут указывать в разные стороны.
4. Данные
Индекс S&P 500 и два ETF, SPY и IVV, с августа 2014 по июль 2015 года, из базы Thomson Reuters Tick History, с метками времени до миллисекунды. Для индекса берутся значения, для ETF цены сделок. Учитывается только основная сессия с 9:30 до 16:00. Очистка по Marshall и соавторам (2013): выброшены наблюдения с логарифмической доходностью больше 25 % по модулю и наблюдения в первые и последние пять минут сессии. В сноске авторы пишут, что при порогах 5, 15, 35 и 45 % результаты те же.
После очистки (таблица 1): 17 745 864 наблюдения индекса, 4 117 085 у SPY и 281 734 у IVV. Медианная доходность у всех нулевая, потому что много сделок подряд идут по той же цене. Средний дневной объём (таблица 2): 525 млн акций у индекса, 29.9 млн у SPY, 0.77 млн у IVV.
5. Кто кого опережает
Таблица 3 работы считается по всей выборке сразу, а не по дням.
| Пара (первый лидер) | Корреляция опережения | Время опережения, мс | LLR |
|---|---|---|---|
| S&P 500 – IVV | 0.1943 | 10 | 1.0058 |
| S&P 500 – SPY | 0.1886 | 30 | 1.0230 |
| IVV – SPY | 0.2370 | 20 | 1.0284 |
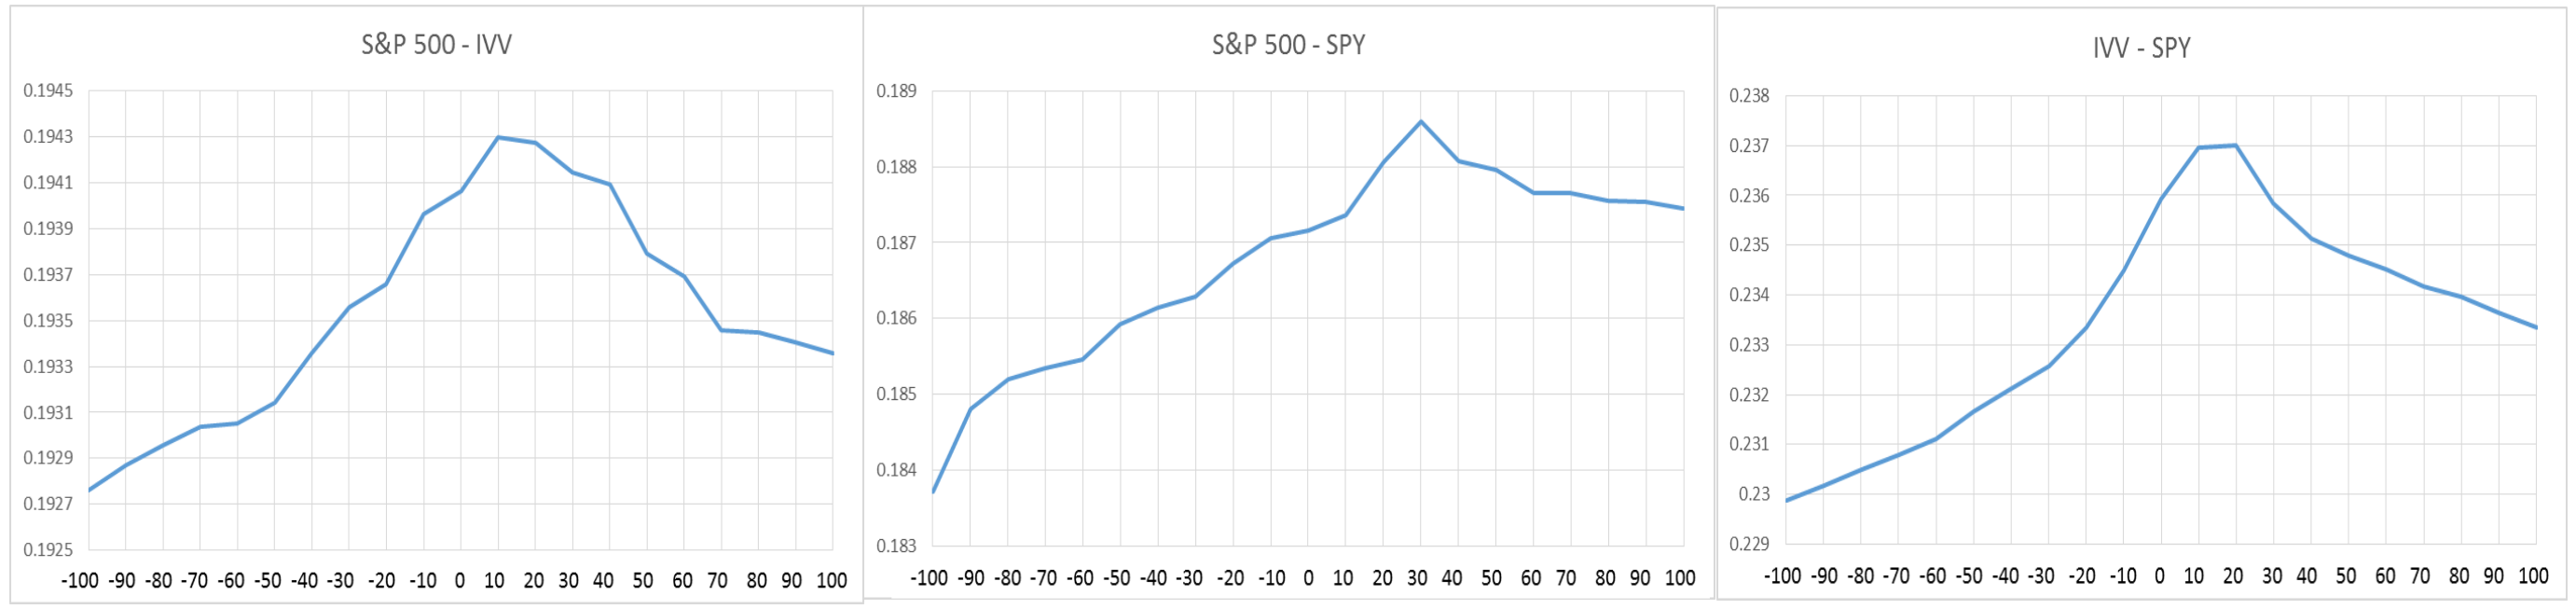
Как его читать. По горизонтали сдвиг метки времени первого инструмента пары в миллисекундах, по вертикали корреляция. Авторы разнесли кривые на три графика, потому что на общем все три выглядели бы прямыми: диапазон корреляции у каждой пары очень узкий. Обратите внимание на вертикальные оси: у пары индекс–IVV весь график укладывается между 0.1925 и 0.1945.
Что нужно увидеть. У всех трёх кривых пик справа от нуля, первый инструмент пары ведёт. От пика корреляция плавно убывает в обе стороны. Кривая ETF–ETF глаже, кривые с IVV симметричнее кривой индекс–SPY. У пары IVV–SPY значения при +10 и +20 мс почти равны.
Практический вывод. Вся разница между «опережает» и «не опережает» здесь лежит в третьем знаке корреляции. Измерение требует миллионов наблюдений, и его точность ограничена шагом сетки 10 мс.
Вывод авторов: индекс опережает оба фонда, "so price discovery starts from the index and the ETFs follow" (раздел 5.1). Корреляция фондов между собой выше, чем с индексом, а LLR чуть больше единицы и выше всего у пары фондов.
6. Как на опережение влияет приход информации
Информацию напрямую не видно, поэтому авторы берут стандартный заменитель: объём торгов. Дневной объём каждого инструмента делится по двум признакам.
Блочный и неблочный. Блочные сделки, крупные по числу или стоимости акций, по Madhavan и Sofianos (1998) обычно инициируют институциональные участники. Авторы используют их как заменитель «искушённых» участников. Неблочный объём это общий минус блочный.
Ожидаемый и неожиданный. По Bessembinder и Seguin (1993) ожидаемый объём дня равен вчерашнему, неожиданный это разница:
Что это такое. Формулы (8) и (9) работы для блочного объёма; для неблочного (10) и (11) устроены так же.
Что означает каждый значок. : блочный объём дня . : ожидаемый блочный объём, просто вчерашний. : неожиданный блочный объём, прирост к вчерашнему. Неожиданный объём служит заменителем прихода информации, ожидаемый обычного уровня активности.
Пример на числах (наш пример). Вчера блочный объём SPY 5 млн акций, сегодня 8 млн. Ожидаемый 5, неожиданный +3 млн. Если сегодня 4 млн, неожиданный −1 млн.
Каждый из трёх показателей опережения (корреляция, время, LLR) по каждому дню регрессируется на четыре компонента объёма обоих инструментов пары (формула 12 работы):
Что означает каждый значок. : показатель опережения дня . : четыре компонента объёма (ожидаемый и неожиданный, блочный и неблочный) в миллионах акций. , : коэффициенты, которые и ищутся. : остаток. Для пары двух фондов в регрессию добавлен ещё и объём индекса (формула 13), всего 12 переменных.
Результаты по LLR, силе лидерства (таблица 4, панель C). Это главный результат работы.
- Индекс–IVV: неожиданный объём лидера (индекса) усиливает лидерство, коэффициенты +0.00196 при блочном и +0.00045 при неблочном, оба значимы на 1 %.
- IVV–SPY: неожиданный объём отстающего (SPY) ослабляет лидерство, −0.00246 при блочном (1 %) и −0.00227 при неблочном (5 %).
- Индекс–SPY: ни одного значимого коэффициента при объёме.
Результаты по корреляции опережения (панель A). Здесь знак зависит от пары. В паре индекс–IVV рост неожиданного объёма лидера снижает корреляцию (−0.00073 при блочном, 5 %), а рост объёма отстающего её повышает (+0.05245 при блочном, 5 %, и +0.03540 при неблочном, 10 %). В двух других парах наоборот: в паре IVV–SPY неожиданный блочный объём лидера IVV повышает корреляцию (+0.04518, 5 %), а неожиданный объём отстающего SPY снижает (−0.00118 при блочном, 5 %, −0.00112 при неблочном, 10 %). Авторы так и формулируют: эффект на корреляцию у лидера и отстающего противоположный, но его направление различается между парами.
Результаты по времени опережения (панель B). Ни один коэффициент при объёме не значим. Свободные члены 9.0 мс, 23.9 мс и 15.4 мс.
Скорректированный регрессий от 0.209 до 0.275 для корреляции, от 0.113 до 0.151 для времени, от 0.139 до 0.252 для LLR.
Величина эффектов (таблица 5). Авторы пересчитывают значимые результаты в изменение показателя при росте объёма на одно стандартное отклонение:
| Пара | Чей объём | Корреляция, абс. | Корреляция, отн. | LLR, абс. | LLR, отн. |
|---|---|---|---|---|---|
| Индекс – IVV | лидера | −0.0477 | −24.57 % | +0.1453 | +14.45 % |
| Индекс – IVV | отстающего | +0.0545 | +28.03 % | −0.0267 | −2.66 % |
| IVV – SPY | лидера | +0.0429 | +18.08 % | +0.0395 | +3.84 % |
| IVV – SPY | отстающего | −0.0553 | −23.35 % | −0.0800 | −7.78 % |
Как читать относительные числа. Они даны в процентах от общего уровня из таблицы 3. Для LLR этот уровень около 1.0, а сама асимметрия, превышение над единицей, составляет 0.006–0.028. Поэтому сдвиг LLR на 0.1453 в отдельный день много больше всей асимметрии по выборке: от дня к дню лидерство гуляет гораздо сильнее, чем видно по годовому числу (наш комментарий).
Авторы делают вывод, что отстающие во всех парах сильнее влияют на корреляцию, чем лидеры, а на LLR сильнее всего влияет объём индекса. И отдельный вывод: блочный объём влияет значимее неблочного, то есть искушённые участники сильнее определяют опережение.
7. Торговая проверка
Раздел 5.1 после рисунка 5 содержит одну фразу о торговле. Авторы применили стратегию Alsayed и McGroarty (2014), торговать отстающего в направлении предыдущего изменения цены лидера: "However, the strategy is not profitable, which is consistent with Brooks et al. (2001), who find that although the lead-lag effect can be used to produce accurate forecasts, trading these forecasts does not yield favourable returns."
Что из этого можно и нельзя вынести. Можно: простейшая стратегия на опережении 10–30 мс у этих инструментов, по словам авторов, денег не дала. Нельзя: почему именно. В работе нет ни доходности, ни числа сделок, ни учёта издержек, ни задержки исполнения, ни периода проверки. Поэтому неизвестно, съели результат комиссии, спред или то, что 10 мс меньше реальной задержки отправки ордера.
8. Что в работе шатко
Оговорки самих авторов
Формулировки осторожные. В аннотации лидерство "may strengthen or weaken depending on whether the leading or lagging instrument responds to that information", и влияние на корреляцию тоже "may also have opposite effects". Первенство заявлено с оговоркой "To our knowledge".
Объём только заменитель информации. Авторы опираются на литературу, где объём используют как заменитель скорости прихода информации, а блочные сделки как заменитель институциональных участников. Прямой проверки, что неожиданный объём связан с новостями, в работе нет.
Что видно при чтении
Торговая проверка без чисел. См. раздел 7. Это единственное место работы, которое касается денег, и оно не проверяемо.
Ожидаемый объём равен вчерашнему. Это самая простая модель ожидания. Регулярные всплески объёма (экспирации, ребалансировки индекса, конец месяца, понедельники) попадут в «неожиданный» объём и будут выглядеть как приход информации.
Объём индекса не описан. У индекса нет собственных сделок, а в таблице 2 у него 525 млн акций в день и в регрессиях есть блочный и неблочный объём индекса. Как эти числа получены (по компонентам индекса или иначе) и что считается блочной сделкой для индекса, в работе не сказано.
Значимость умеренная, наблюдений немного. Регрессии дневные на одном году данных (около 250 торговых дней; точного числа дней в работе нет), с 8 или 12 переменными. Большинство значимых коэффициентов при объёме на уровне 5 или 10 %; на 1 % значимы три коэффициента в панели LLR. Поправки на то, что проверяется много коэффициентов в девяти регрессиях, нет.
Объём и опережение одного дня. Объём и показатели опережения берутся за один и тот же день. Регрессия показывает связь, но не говорит, что объём вызывает изменение лидерства, а не наоборот. Это ограничение дизайна, а не ошибка; авторы формулируют вывод как влияние.
Направление эффекта на корреляцию не одинаково по парам. В паре индекс–IVV объём лидера снижает корреляцию, в паре IVV–SPY повышает. Авторы это отмечают, но не объясняют.
Сетка 10 мс грубая для таких задержек. Время опережения 10 мс у пары индекс–IVV это первый шаг сетки, а у пары IVV–SPY корреляции при +10 и +20 мс почти равны. Более быстрые эффекты метод не различит.
Менее ликвидный фонд опережает более ликвидный. У IVV в 15 раз меньше наблюдений и почти в 40 раз меньше объём, чем у SPY, но по таблице 3 он опережает SPY на 20 мс. В работе это не обсуждается. Наше замечание.
Два рисунка с номером 5. В авторской версии схема для объяснения LLR (страница 12) и реальные кривые корреляции (страница 17) обе подписаны как рисунок 5. На выводы не влияет, но при ссылках на рисунки стоит указывать страницу.
Период данных старый. Август 2014 – июль 2015 года. Инфраструктура рынков с тех пор менялась, и абсолютные задержки, скорее всего, тоже.
9. Что из этого следует на практике
Корреляцию несинхронных рядов считать по пересекающимся промежуткам. Оценка Hayashi–Yoshida не требует выравнивания по сетке и не выдумывает точек. Это подходит для любой пары с собственным ритмом сделок: разные биржи, спот и фьючерс, фонд и его корзина.
Опережение описывать тремя числами. Положение пика, его высота и LLR по всей кривой. Пик в одну сторону при LLR в другую означает, что «лидер» ведёт только на узком отрезке сдвигов.
Корреляция без частоты замеров не число. 99.9 % на днях и около 20 % на тиках для одной и той же пары. Решения, принятые по дневным корреляциям, не переносятся на внутридневные масштабы.
Задержку опережения сравнивать со своей задержкой до всяких бэктестов. Если лидер опережает на 10–30 мс, а путь от получения данных до попадания ордера на биржу дольше, стратегия закрыта. По работе время опережения не зависит от дневного объёма, поэтому его разумно измерять отдельно и пересматривать при изменениях инфраструктуры (наш вывод из панели B).
Сила лидерства меняется от дня к дню. В дни, когда необычно много торгует отстающий инструмент, лидерство слабее. Это проверяемая гипотеза для фильтра сигнала, но в работе она подтверждена на одном году данных и на уровнях значимости 1–5 %.
Статистическая различимость не прибыль. LLR 1.02 отличим от единицы на миллионах наблюдений, и простейшая стратегия на нём, по словам авторов, неприбыльна.
10. Тестируемые идеи
| № | Идея | Тип | Где считать |
|---|---|---|---|
| 1 | Реализовать корреляцию Hayashi–Yoshida по пересекающимся промежуткам и сравнить с корреляцией по выровненным барам на своих парах с несинхронными сделками | диагностика | Python |
| 2 | Строить кривую корреляции по сдвигу (например, от −500 до +500 мс) для своих пар площадок или инструментов и отчитывать три числа: пик, его положение и LLR | диагностика | Python |
| 3 | Сравнить измеренное время опережения со своей задержкой от получения данных до попадания ордера на биржу; если своя больше, идею закрыть до бэктеста | метрика приёмки | любая |
| 4 | Отчитывать LLR рядом с положением пика и отдельно помечать пары, где пик и LLR указывают в разные стороны | аудит | Python |
| 5 | Построить корреляцию пары как функцию частоты замеров (тик, 1 с, 10 с, 1 мин, 5 мин, час, день), чтобы увидеть, с какого масштаба корреляционные оценки вообще применимы | диагностика | Python |
| 6 | Считать LLR и время опережения по каждому дню и проверить, слабеет ли лидерство в дни с аномальным объёмом отстающего, как в паре IVV–SPY | диагностика | Python |
| 7 | Заменить «ожидаемый объём = вчерашний» на среднее за 20 дней с поправкой на день недели и экспирации и проверить, сохраняются ли эффекты объёма | аудит | Python |
| 8 | Разделить поток на крупные и мелкие сделки и проверить, какая часть сильнее связана с силой лидерства | диагностика | Python |
| 9 | Повторить простейшую стратегию «торговать отстающего в сторону последнего движения лидера» с явными издержками и задержкой исполнения, чтобы получить числа, которых нет в работе | метрика приёмки | бэктестер |