Как читать этот разбор. Это не работа о рынках, а диссертация по системному программированию. Трейдеру она нужна по одной причине: торговая система обязана записывать, что она видела и что сделала, иначе разбор живой сессии невозможен, а запись в журнал в горячем пути может стоить дороже самого решения. Работа показывает, как сделать запись почти бесплатной и чем за это платят. Главный вывод в разделе «Метод в одну строку». Самое переносимое в торговый код собрано в разделе 4 про устройство буфера: эти приёмы годятся для любой очереди между потоками, от рыночных данных к стратегии и от стратегии к исполнению. Главы о метапрограммировании C++17 и о сжатии (4, 6, 8) пересказаны коротко, их можно пропустить.
1. Зачем трейдеру работа о журналировании
Журнал (лог) это строки вида «время, файл, строка кода, уровень, сообщение», которые программа пишет во время работы. По ним потом восстанавливают, что произошло: почему ордер ушёл с опозданием, почему стратегия не вошла, где система получила старую котировку. Чем больше событий записано, тем полезнее журнал.
Автор начинает с того, что журнал стал дорогим относительно самих программ. Форматирование одной строки в типичной системе занимает 0.5–1 мкс, это 1000–2000 тактов процессора. Одно сообщение весит 50–100 байт, поэтому диск на 250 МБ/с принимает всего несколько миллионов сообщений в секунду. Для серверов, которые отвечают за 1–2 мкс, одна строка журнала может удвоить время ответа. Автор пишет, что в Google и VMware на ревью кода спорят, оставить строку журнала или убрать ради скорости, и подытоживает: "Logging itself is expensive, but lacking proper logging is very expensive." (глава 1).
Для торговой системы ситуация та же, только масштаб жёстче: если сигнал живёт десятки миллисекунд, а запись «отправил ордер» стоит микросекунду в горячем пути, журналирование начинает конкурировать с самим решением. Обычный выход, которым пользуются и программисты вне торговли, это писать меньше: поднимать порог важности, выборочно пропускать сообщения, вычищать «лишние» строки. Автор отмечает, что все эти приёмы покупают скорость ценой видимости.
2. Метод в одну строку
В горячем пути записывать в память только то, что меняется от вызова к вызову (метку времени, номер сообщения, значения аргументов), в двоичном виде; всё неизменное записать в файл один раз; текст для человека собирать отдельной программой после работы.
Идея держится на двух наблюдениях автора (раздел 2.3). Первое: большинство сообщений человек никогда не читает, их потребляют другие программы, а человек смотрит малую долю журнала при отладке. Второе: в строке вроде Creating table 'orders' with id 11 меняются только время, номер потока, имя таблицы и число 11. Имя файла, номер строки, уровень и шаблон сообщения известны при компиляции и повторяются в каждом вызове.
Отсюда три части системы (рисунок 3.1 работы):
- на этапе компиляции отдельный компонент находит все вызовы журнала, вынимает из них постоянную часть в словарь и генерирует для каждого вызова свою функцию записи
record()и функцию сжатияcompress(), без разбора строки формата во время работы; - во время работы поток копирует метку времени, номер сообщения и аргументы в свой буфер в памяти и сразу возвращается; фоновый поток забирает данные, сжимает и пишет на диск;
- после работы отдельная программа соединяет словарь с двоичными записями и печатает обычный текст или отдаёт записи программе анализа без превращения в текст.
Метку времени система берёт прямо из счётчика тактов процессора (Intel TSC) и не переводит в часы и минуты во время работы: соответствие счётчика и настенного времени записано в заголовке файла, перевод делает программа постобработки (раздел 5.3).
3. Где выигрываются наносекунды
Автор называет четыре приёма, на которых держится скорость (раздел 3.1 и глава 12).
Отложенное форматирование. Самый дорогой шаг убран из работы целиком: строка формата не разбирается, числа в текст не переводятся.
Разделение постоянного и меняющегося. Постоянная часть записывается в файл один раз, дальше на каждый вызов пишется только номер сообщения и аргументы. Для полностью постоянного сообщения это 3–4 байта вместо 41–90 байт у других систем (раздел 9.1.3).
Заранее сгенерированная логика. Разбор строки формата во время работы требует много ветвлений, а они плохо уживаются с внеочередным исполнением и предсказанием переходов в процессоре. Функции, сгенерированные под каждый вызов, выполняются прямым кодом почти без ветвлений.
Лёгкое сжатие. После удаления постоянной части в журнале остаются в основном целые числа, причём маленькие: номер сообщения обычно умещается в 1–2 байта, хотя под него отведено 4, разница меток времени меньше 15 мс умещается в 3 байта из 8. Поэтому вместо словарных алгоритмов вроде gzip автор отбрасывает старшие нулевые байты и пишет короткий признак длины (глава 8). Строки и дробные числа так не сжимаются.
Что такое горячий путь. Участок кода, который выполняется на каждое событие и от скорости которого зависит время реакции системы. В торговой системе это путь от прихода рыночных данных до отправки ордера. Всё, что можно сделать потом или в другом потоке, из горячего пути выносится.
4. Промежуточный буфер: глава 7 по шагам
Глава 7 самая полезная для любого, кто пишет многопоточный торговый код. Автор начинает с простейшего решения и улучшает его по шагам, от задержек в микро- и миллисекунды до единиц наносекунд.
Шаг 0: общая очередь с блокировкой. Все потоки пишут в одну очередь, защищённую одной блокировкой (mutex). Плюс один: порядок сообщений получается сам собой. Минусов три. Все потоки выстраиваются в очередь друг за другом. Фоновый поток не может читать, пока кто-то пишет. И сама блокировка дорогая: запись в NanoLog занимает около семи наносекунд, а "a lock operation can take several times longer as it requires explicit and excessive cache synchronization" (раздел 7.2). Хуже того, некоторые реализации блокировок усыпляют ждущий поток, и тогда операция на наносекунды растягивается на миллисекунды, пока операционная система не вернёт поток к работе.
Шаг 1: свой буфер у каждого потока. Потоки, которые пишут журнал, перестают встречаться друг с другом. Платят за это двумя вещами: выделением памяти при создании потока (не больше одного раза на поток) и потерей общего порядка. Внутри одного буфера сообщения упорядочены по времени, между буферами нет. Сортировка переносится в постобработку. Выделение памяти можно сделать заранее отдельным вызовом, чтобы оно не совпало с критичным по времени участком.
Шаг 2: без блокировок, у каждой переменной один писатель. Буфер это кольцо с двумя отметками: producerPos, куда пишет поток приложения, и consumerPos, откуда читает фоновый поток. Первую меняет только пишущий поток, вторую только фоновый, читать обе может каждый.
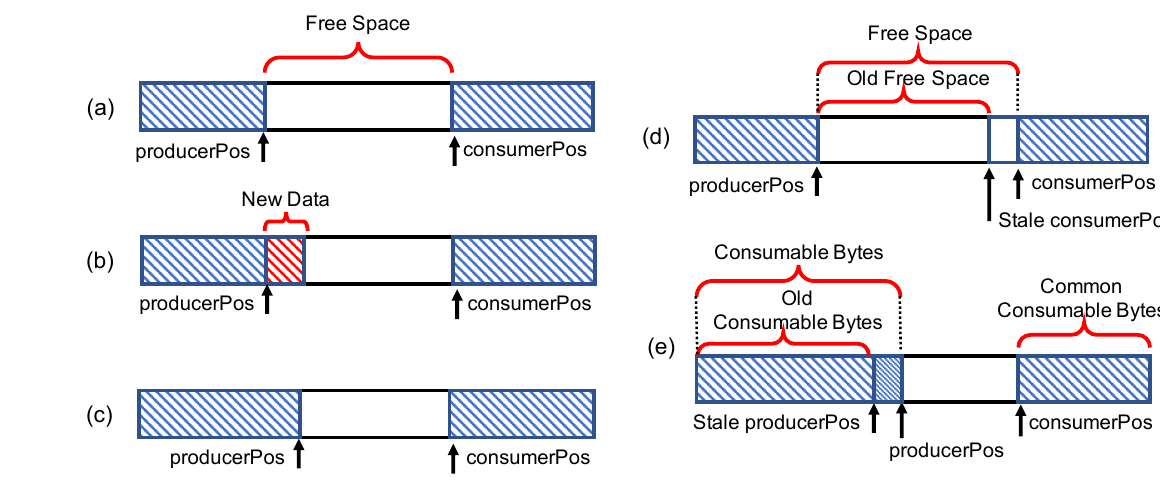
Как его читать. Заштрихованные участки заняты данными, белые свободны. Части (a)–(c) показывают запись: (a) свободное место считается как разница между позицией читателя и позицией писателя; (b) если места хватает, новые данные копируются в позицию писателя; (c) позиция писателя сдвигается за новые данные.
Что нужно увидеть. Части (d) и (e) объясняют, почему блокировка не нужна. В (d) писатель пользуется устаревшим значением позиции читателя (
Stale consumerPos). Читатель за это время мог продвинуться и освободить ещё место, поэтому «старое свободное место» (Old Free Space) всегда меньше настоящего и целиком в нём лежит. В (e) то же с другой стороны: читатель по устаревшей позиции писателя видит меньше готовых данных, чем есть.Практический вывод. Если ошибка от устаревшего значения всегда в осторожную сторону, синхронизация не нужна: в худшем случае поток зря откажется писать или прочтёт данные на следующем круге, но никогда не затрёт непрочитанное.
Автор формулирует это так: свободное место со временем может только расти, поэтому "using an old value would only at worse underestimate the free space" (раздел 7.4). Два условия при этом обязательны, и их легко упустить, если переносить приём в свой код. Первое: порядок операций с памятью. Писатель сначала кладёт данные и ставит барьер записи (store fence), и только потом сдвигает свою позицию; читатель сначала дочитывает данные с барьером чтения (load fence), и только потом сдвигает свою. Второе: в сноске автор оговаривает допущение "Individual reads and writes to single-word values are assumed to be atomic." (раздел 7.4). Есть и третья деталь: когда запись не помещается в конец кольца, писатель отмечает конец занятой области отдельным указателем и переходит в начало; этот указатель тоже пишется до сдвига позиции.
Если места не хватает, функция записи возвращает ошибку и повторяет попытку. Иначе говоря, при переполнении буфера пишущий поток ждёт. Это важная деталь для торговой системы, к ней вернёмся в разделе 6.
Шаг 3: запоминать чужую позицию. Схема без блокировок всё ещё дорогая под нагрузкой: чтобы посчитать свободное место, писатель на каждой записи читает позицию, которую только что изменил другой поток на другом ядре. Такое чтение промахивается мимо кэша, и "This cache miss can slow the operation by tens of nanoseconds" (раздел 7.5), то есть в несколько раз дороже самой записи. Если оба потока работают в такт, промах случается на каждой операции.
Решение: каждый поток держит у себя счётчик свободного (или готового к чтению) места, вычитает из него при каждой операции и идёт читать чужую позицию только тогда, когда счётчик кончился. Это безопасно по той же причине, что и шаг 2: запомненное значение равносильно намеренно «замороженной» устаревшей позиции, а устаревшая позиция никогда не завышает свободное место.
Как это работает на числах (наш пример, в работе чисел нет). Буфер 1 МБ, средняя запись 100 байт. Без запоминания писатель читает позицию читателя на каждой из 10 000 записей, которые помещаются в буфер: 10 000 дорогих чтений. С запоминанием он один раз узнал, что свободно 500 КБ, и следующие примерно 5 000 записей вообще не трогает чужую память. Число дорогих обращений падает в тысячи раз, если читатель успевает освобождать место.
Шаг 4: разнести переменные по разным линиям кэша. Даже после шага 3 счётчики писателя и читателя могут оказаться в одной линии кэша. Тогда запись в свой счётчик выбивает из кэша соседний счётчик другого потока, хотя логически они независимы. Это и есть ложное разделение (false sharing). NanoLog вставляет между переменными писателя и переменными читателя пустой массив размером в линию кэша.
Что такое линия кэша и ложное разделение. Процессор переносит память между ядрами не по байтам, а блоками фиксированной длины, на распространённых x86-процессорах это 64 байта (размер наш, в работе он не назван). Если ядро A изменило переменную, копия всего блока в кэше ядра B считается устаревшей, и B при следующем обращении идёт за свежей копией. Когда в одном блоке лежат две независимые переменные, которые пишут разные потоки, они мешают друг другу без всякой логической связи. При чтении кода этого не видно.
Шаг 5: опрос вместо сигнала. Классический способ сообщить фоновому потоку, что появились данные, это условная переменная (condition_variable::notify()). Автор её измерил: "The notify operation takes on the order of 14 nanoseconds in my measurements" (раздел 7.7), вдвое больше целевых 7 нс на всю запись. Поэтому поток приложения не сигналит никому, а фоновый поток сам обходит буферы по кругу. Обратная сторона: между кругами опроса фоновый поток спит, и это видно на хвосте задержек (раздел 5).
Шаг 6: служебные данные всех буферов подряд. Сначала служебные поля каждого буфера (позиции, счётчики, разделители) лежали рядом с его хранилищем, и служебные поля соседних буферов оказывались в памяти на расстоянии размера хранилища. Предвыборка процессора не угадывала следующий адрес. Когда служебные поля всех буферов собрали в один непрерывный участок, опрос каждого буфера подешевел примерно на один промах кэша (раздел 7.8).
Итог главы в словах автора: буферы работают "in the range of single digit nanoseconds vs. the micro- to milliseconds incurred by a centralized, monitor-style queue" (раздел 7.9).
5. Что показали замеры
Стенд (таблица 9.1): четырёхъядерный Xeon X3470 на 2.93 ГГц, 24 ГБ памяти, SSD Samsung 850 PRO с измеренной скоростью около 250 МБ/с на больших записях, Debian 8.3 с ядром Linux 3.16.7. Сравнивались Log4j2, spdlog, glog, Boost Log и Event Tracing for Windows (ETW) на шести сообщениях из открытого хранилища RAMCloud: от полностью постоянной строки до строки с длинным изменяемым текстом.
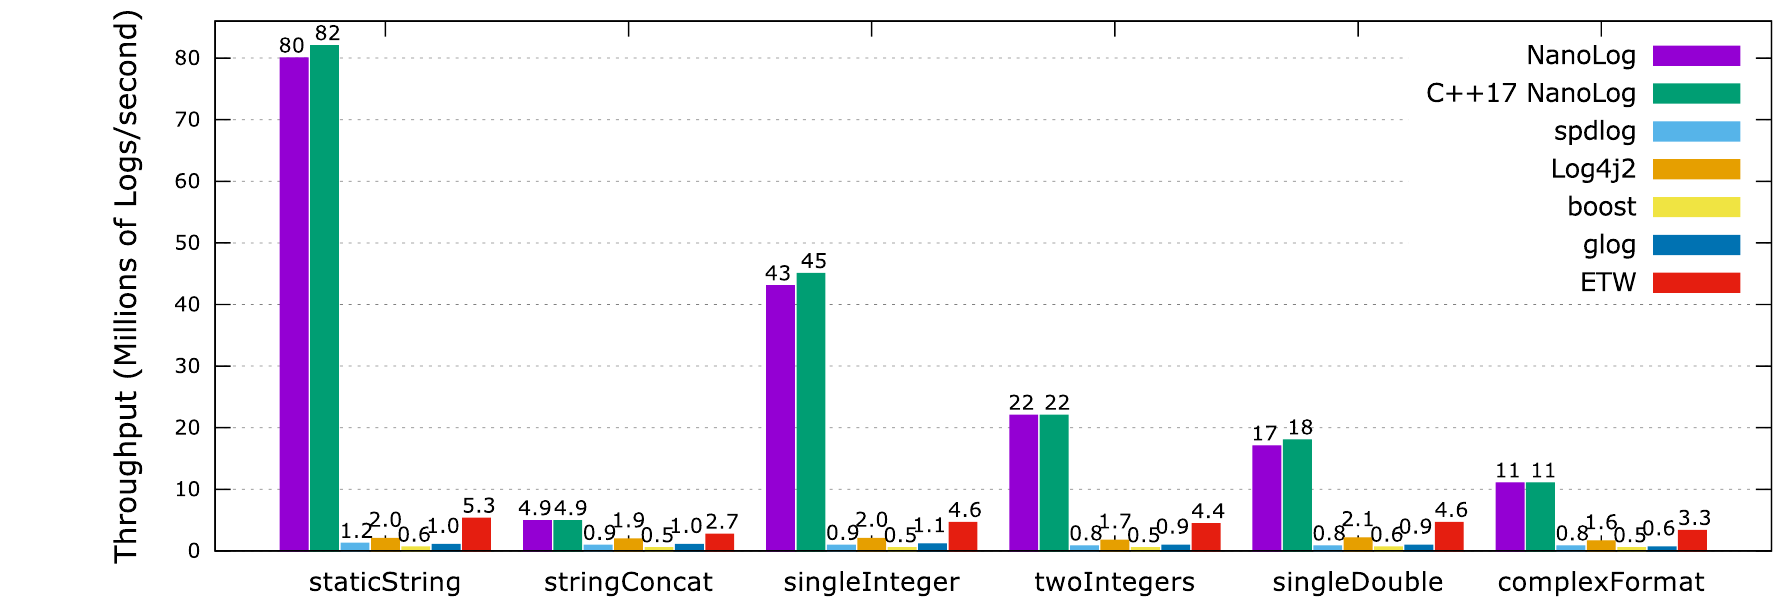
Как его читать. По горизонтали шесть сообщений бенчмарка, по вертикали миллионы сообщений в секунду. В каждой группе семь столбиков: две версии NanoLog и пять других систем. «NanoLog» здесь версия с препроцессором, «C++17 NanoLog» версия на шаблонах C++17. Число потоков менялось от 1 до 16, показан лучший результат; у всех систем, кроме Log4j2, в замер входит сброс на диск.
Что нужно увидеть. На постоянной строке (staticString) NanoLog выдаёт 80–82 млн сообщений в секунду против 0.6–5.3 млн у остальных. На строке с длинным изменяемым текстом (stringConcat) разрыв почти исчезает: 4.9 млн против 0.5–2.7 млн. NanoLog не сжимает строки и пишет их целиком, поэтому чем больше в сообщении текста, тем меньше его преимущество.
Практический вывод. Выигрыш NanoLog это выигрыш в байтах на сообщение. Журнал торговой системы, где в сообщениях в основном числа (цены, объёмы, идентификаторы), ближе к правой половине графика, к сообщениям с целыми и дробными числами, где NanoLog выдаёт 11–45 млн.
По задержке одного вызова (таблица 9.4: один поток, 100 000 вызовов подряд с паузой 600 нс между ними) медиана NanoLog 7–8 нс, а 99.9-й перцентиль от 27 до 37 нс. У ETW медиана 180–242 нс, у Log4j2 146–230 нс, у spdlog 230–1234 нс, у glog 1201–2570 нс, у Boost 1619–4175 нс. Автор сводит это так: задержка вызова у NanoLog в 18–500 раз ниже, чем у других систем.
Встраивание в настоящее приложение. Автор встроил NanoLog и spdlog в хранилище «ключ–значение» RAMCloud, включил все подробные сообщения и добавил постоянные замеры производительности, всего 11–33 вызова журнала на запрос чтения или записи (таблица 9.6). С NanoLog медианная задержка чтения выросла на 3 %, записи на 3–4 %, пропускная способность записи упала на 2 %, чтения на 19 % (поток диспетчеризации RAMCloud и без того узкое место на чтении). С spdlog задержки выросли в 1.6 раза, пропускная способность чтения упала до 12 % исходной, со встроенным журналом RAMCloud до 7 %.
Из этих чисел автор оценивает цену одного вызова в реальной работе:
Что это такое. Цена одного вызова журнала внутри настоящего приложения, а не в микротесте.
Что означает каждое число. 5.33 мкс: медианная задержка чтения в RAMCloud с журналом NanoLog. 5.19 мкс: она же без журнала. 8: сколько из включённых сообщений лежит на критическом пути одного чтения.
Счёт по шагам. Вычесть одно время из другого: 0.14 мкс добавил журнал. Разделить на 8 вызовов: 0.0175 мкс на вызов, то есть 17.5 нс. Для записи (27 вызовов на критическом пути) автор получает 17.7 нс.
Зачем это нужно. Это в 2–2.5 раза больше 7–8 нс из микротеста. Автор предполагает, что разница от промахов кэша на буферах, и прямо пишет, что проверить это глубже не смог. Для spdlog такой же расчёт даёт около 380 нс, близко к микротесту.
Сборка RAMCloud с версией на препроцессоре стала дольше на 17 %, бинарник больше на 16 %; с версией C++17 сборка дольше на 2 %, бинарник больше на 19 %.
Где узкое место. Рисунок 9.5 показывает, что именно ограничивает пропускную способность.
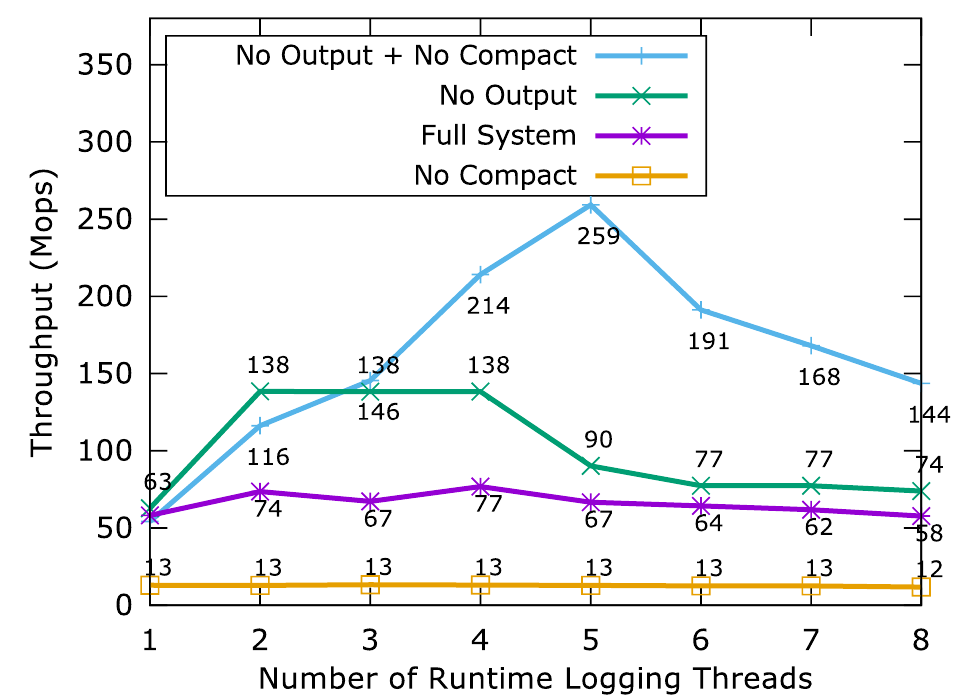
Как его читать. По горизонтали число потоков, которые пишут журнал (от 1 до 8), по вертикали миллионы сообщений в секунду. Full System это обычная работа. No Output отправляет журнал в
/dev/null, то есть убирает диск. No Compact выключает сжатие. No Output + No Compact убирает и то, и другое.Что нужно увидеть. Без сжатия пропускная способность падает до 13 млн: сообщение весит около 16 байт вместо 3–4, и диск не успевает. Без диска она поднимается до 138 млн, и узким местом становится уже сжатие. Без того и другого до 259 млн при пяти потоках, дальше падает: у машины 4 физических ядра, и потоки приложения начинают отнимать процессор у фонового потока.
Практический вывод. На обычном железе предел задаёт объём байтов на диск, а не код записи. Отсюда ценность сжатия в горячем пути, которое на первый взгляд кажется лишней работой.
Автор показывает, почему сжатие нельзя просто выбросить при более быстром диске:
Счёт по шагам. 138 млн сообщений в секунду (столько выдаёт система без диска) умножить на 16 байт несжатого сообщения: около 2.2 млрд байт в секунду. Такой диск нужен, чтобы без сжатия держать ту же скорость, а не диск вдвое быстрее стендового.
Хвост задержки и размер буфера. Рисунок 9.6 нужен тому, кто думает о худшем случае, а не о медиане.
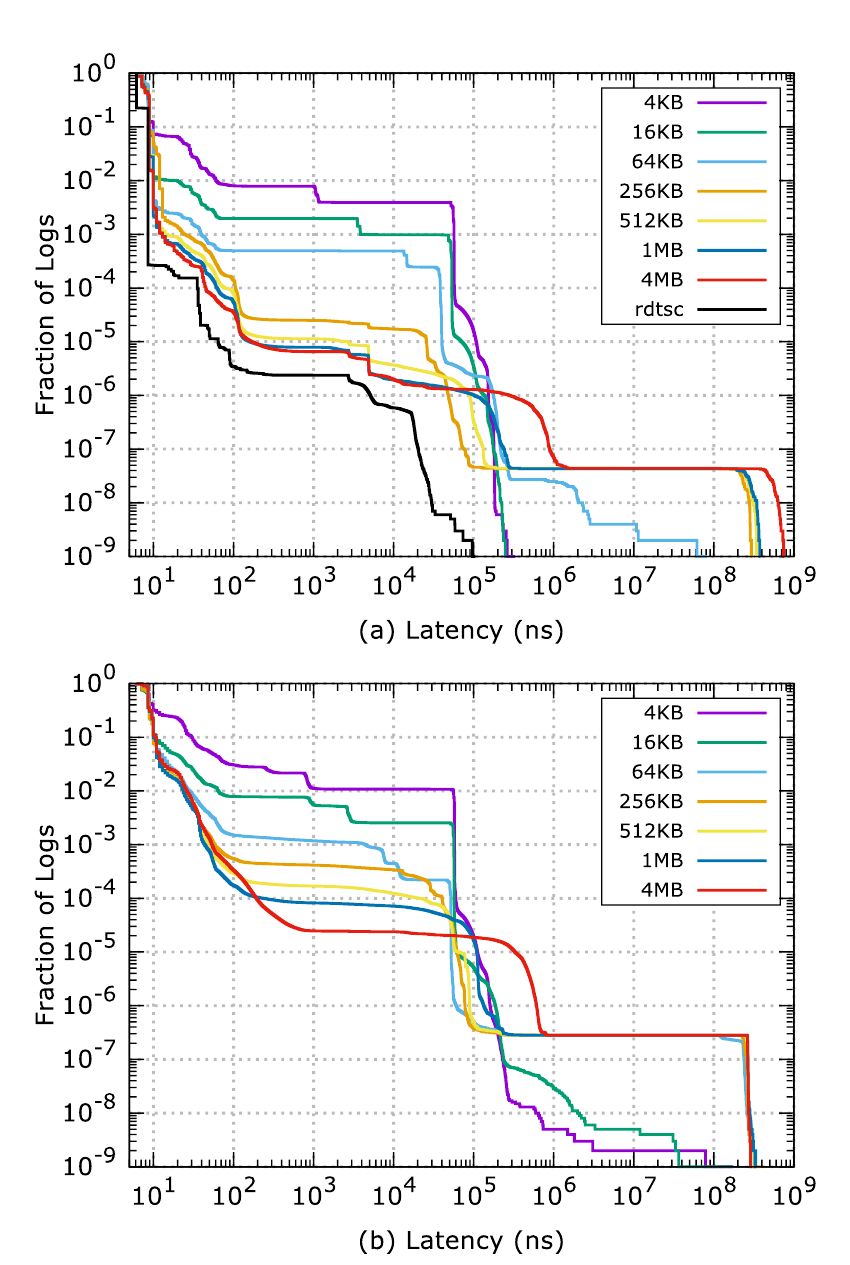
Как его читать. Это дополнительная функция распределения (CCDF): точка (x, y) значит, что доля y всех вызовов заняла не меньше x наносекунд. Обе оси логарифмические. Верхняя панель для постоянной строки, нижняя для сложного сообщения. На каждой кривой миллиард вызовов подряд без пауз одним потоком, то есть журнал заведомо пишется быстрее, чем успевает диск. Чёрная линия rdtsc на верхней панели: миллиард чтений счётчика тактов подряд, нижняя граница того, что вообще возможно на этой машине.
Что нужно увидеть. Независимо от размера буфера 90 % вызовов быстрее 10 нс. Чем больше буфер, тем больше доля быстрых вызовов: при 4 КБ около 90 %, при 512 КБ 99.8 %; дальше 512 КБ выигрыш почти не растёт. Затем две ступени. Около 50 мкс: фоновый поток спит между кругами опроса, и маленький буфер успевает заполниться. Около 100+ мс: заполнился выходной буфер на 64 МБ, и все ждут диска.
Неожиданное следствие. Самая медленная запись хуже у большого буфера. При 4 КБ худший вызов занимает десятки микросекунд, при 4 МБ сотни миллисекунд. Автор объясняет: маленький буфер часто и коротко тормозит пишущий поток, и диск успевает; большой копит больше и потом ждёт диска дольше. По его словам,
"the more frequent the stalls, the better the worst-case performance"(раздел 9.6).
По умолчанию NanoLog ставит буфер 1 МБ, после которого доля быстрых вызовов почти не растёт. Автор сразу оговаривает, что опыт искусственный: приложение только пишет журнал и ничего не делает между вызовами. При разумном темпе, например одно сообщение на 1000 нс, он ожидает хвост заметно лучше и ближе к линии rdtsc, но и тогда возможны задержки около 100 мкс по причинам вне приложения.
Остальное из главы 9 коротко. Программа постобработки однопоточная и переводит в текст около 0.5 млн сообщений в секунду; почти всё время уходит на форматирование даты и контекста, около 2 мкс на сообщение. Сортировка 4096 потоков снижает её скорость примерно на 10 %. Агрегация (минимум, среднее, максимум по одному сообщению) прямо по двоичному журналу стоит 35–44 нс на сообщение против 350+ нс у C++, awk и Python по текстовому журналу; двоичный файл весил около 747 МБ против 7.6 ГБ текста, и разница почти целиком объясняется объёмом чтения с диска.
6. Что в работе шатко
Оговорки самого автора
Микротесты описывают лучший случай. Про таблицу задержек автор пишет, что результаты "may represent an unrealistic, best-case performance for all logging systems" (раздел 9.1.4): приложение в тесте только пишет журнал, ничем не загрязняет кэш и не соперничает за диск и процессор. Встраивание в RAMCloud это подтверждает: 17.5 нс вместо 7–8.
Опыт с хвостом задержки искусственный. "this benchmark is a bit unrealistic/contrived" (раздел 9.6). Он показывает поведение при переполнении, а не при обычной нагрузке.
При переполнении пишущий поток ждёт. NanoLog гарантирует, что ни одно сообщение не потеряется, и платит за это блокировкой: "NanoLog can block, but will never miss any critical events" (раздел 11.5). Системы трассировки вроде KUTrace поступают наоборот: перезаписывают старые события и никогда не тормозят приложение. Автор прямо признаёт, что разброс задержки у NanoLog из-за этого больше, чем у них, и описывает, как приблизить NanoLog к трассировщику: отключить фоновый поток, сбрасывать на диск после окна наблюдения, увеличить буфер, ограничить число аргументов.
Порядок событий восстанавливается потом, и есть редкий случай, когда это может не сработать. Постобработка держит два раунда вывода и сливает их по меткам времени. Если поток прочитал счётчик тактов, был вытеснен планировщиком и не дописал аргументы дольше двух раундов, его сообщение окажется в файле позже более поздних. Автор поставил на этот случай проверку и пишет, что она ни разу не сработала, хотя на 4–8 ядрах крутились тысячи потоков; в версии на GitHub на всякий случай держится три раунда (раздел 6.1.4).
Четыре принципиальных ограничения (раздел 10.2). Система добавляет в сборку отдельный шаг и отдельную программу постобработки, то есть новые точки отказа. Если журнал всё равно нужен человеку в виде текста, в сумме ресурсов уходит больше, чем у обычной библиотеки, и автор формулирует условие применимости: "NanoLog only makes sense in situations where runtime performance is paramount". Работает только стиль printf с постоянной строкой формата; динамические строки формата и вывод структур данных не поддерживаются. И наконец, "NanoLog is not a silver bullet to application visibility": что и где журналировать, по-прежнему решает разработчик, а лишние сообщения затрудняют разбор.
Объяснения, которые автор не проверял. Почему ETW медленнее при похожей конструкции (ETW закрыт, замерить глубже не удалось), почему вызов в RAMCloud дороже микротеста, почему выигрыш от буфера перестаёт расти после 512 КБ, почему сжатие иногда быстрее простого копирования памяти. Везде стоит «I suspect» или прямое «не проверял».
Будущее системы. В заключении автор не ждёт, что прототип станет стандартом: "I don't envision that the NanoLog system will become a staple of logging anytime soon" (раздел 12.1). Он рассчитывает на перенос приёмов в другие системы.
Что видно при чтении
Все замеры сделаны автором на своей системе. Конкуренты настроены по описанию автора (spdlog с буфером 8192 записи, glog с буфером на 30 секунд, Log4j2 с асинхронными логгерами и LMAX Disruptor), независимого повторения в работе нет. spdlog выбран, по словам автора, как первый результат поиска «Fast C++ Logger». Это не делает сравнение нечестным, но означает, что конкурентов можно было настроить и иначе.
Железо старое для 2020 года. Четырёхъядерный Xeon и SATA SSD на 250 МБ/с. Абсолютные числа на современном сервере и NVMe-диске будут другими; автор сам показывает (рисунок 9.5), что при более быстром диске узким местом становится сжатие.
Разные числа в разных местах описывают разные сообщения, а не противоречие. В аннотации "typical log invocation overhead of 8 nanoseconds" и до 82 млн сообщений в секунду, в разделе «Industrial Response To NanoLog» перед оглавлением "median invocation latency of 7-19 nanoseconds", в главе 1 около 80 млн. 82 млн это версия C++17 на постоянной строке, 80 млн версия с препроцессором. Читателю стоит брать числа из таблицы 9.4 и рисунка 9.2 вместе с типом сообщения.
Перенос в Python невозможен напрямую. Это наше замечание, не автора: приёмы главы 7 опираются на модель памяти C++ и на барьеры, которых у интерпретатора с глобальной блокировкой нет в том же виде. Применимы они к частям системы на C++ или Rust.
7. Что из этого следует на практике
Журналировать в горячем пути можно, если не форматировать. Писать двоичную запись минимального объёма с меткой из счётчика тактов, превращать её в текст другим процессом, на другом ядре или другой машине. Это снимает выбор между «писать журнал» и «быть быстрым», который автор считает ложным.
Правило одного писателя вместо блокировки. Для любой разделяемой структуры проверить две вещи: у каждой переменной ровно один поток, который её пишет, и устаревшее значение ошибается в безопасную сторону. Если оба условия выполнены, блокировку можно снять, но только вместе с правильными барьерами памяти.
Не читать чужую переменную на каждой итерации. Запомнить последнее значение и перечитывать, когда запас кончился. Это дешёвое изменение с эффектом на числе промахов кэша.
Проверять раскладку полей в структурах, которые трогают разные потоки. Ложное разделение не видно в коде и не ловится профилировщиком, который показывает время по функциям.
Решить заранее, что делать при переполнении. Ждать (как NanoLog) значит рисковать задержкой ордера на сотни миллисекунд в худшем случае; выбрасывать (как трассировщики) значит терять события в самый интересный момент. Размер буфера сдвигает этот выбор: большой буфер делает редкие задержки длиннее, маленький делает их чаще и короче.
Мерить хвост, а не среднее. Медиана 7 нс ничего не говорит о вызове на сто миллисекунд раз в миллиард. График вроде рисунка 9.6 показывает это сразу.
Порядок событий это проектное решение с ценой. Буфер на поток быстрее общей очереди, но требует меток времени в каждой записи и сортировки при разборе. Для журнала, по которому восстанавливают последовательность торговых решений, это нужно решить явно.
8. Тестируемые идеи
| № | Идея | Тип | Где считать |
|---|---|---|---|
| 1 | Померить цену одного вызова журнала в горячем пути своей системы по медиане и 99.9-му перцентилю, отдельно в микротесте и под реальной нагрузкой (по примеру расчёта 17.5 нс из RAMCloud) | диагностика | любая |
| 2 | Перевести журнал горячего пути на двоичную запись аргументов с форматированием в отдельном процессе и сравнить задержку от прихода данных до отправки ордера до и после | изменение конструкции | любая |
| 3 | Пройти все межпоточные структуры: у каждой переменной один писатель, устаревшее значение ошибается в безопасную сторону, барьеры памяти стоят до сдвига позиции | аудит | любая |
| 4 | Заменить чтение позиции другого потока на каждой итерации запомненным счётчиком свободного места и сравнить задержку под нагрузкой | изменение конструкции | любая |
| 5 | Проверить раскладку полей в разделяемых структурах и разнести поля разных писателей по разным линиям кэша; померить разницу | аудит | любая |
| 6 | Отчитывать задержку системы как дополнительную функцию распределения до уровня 10⁻⁶ и ниже, а не средним | метрика приёмки | Python |
| 7 | Прогнать всплеск событий быстрее, чем успевает диск, при разных размерах буфера и выбрать размер по худшему вызову, а не по медиане | диагностика | любая |
| 8 | Проверить при постобработке, что сообщения разных потоков после слияния идут по неубывающим меткам времени, и считать нарушения | аудит | Python |
| 9 | Заменить сигнал фоновому потоку (условная переменная) опросом и сравнить задержку записи и нагрузку на ядро | изменение конструкции | любая |