Как читать этот разбор. Весь метод помещается в раздел 2 «Метод в одну строку»; его можно применить, не читая остального. Раздел 1 объясняет, почему обычная оптимизация ломается, и это самая содержательная часть работы. Раздел 3 про то, почему сжимать надо так сильно; раздел 4 про связь с известными методами, его можно пропустить. Результаты в разделах 5–7, оговорки в разделе 8. Примеры с пометкой «наш пример» взяты из нашего рабочего разбора; числа работы мы не пересчитывали.
Главный тезис
Теория говорит, что портфельная оптимизация должна давать инвестору много. На практике стандартная средне-дисперсионная оптимизация (MVO, Markowitz, 1952) работает так плохо, что от неё часто отказываются. Авторы во введении: "MVO often produces large and unintuitive bets that perform poorly in practice". Известно и то, что простой портфель 1/N, где капитал делится поровну, обыграть оптимизацией на удивление трудно (DeMiguel, Garlappi и Uppal, 2007).
Работа делает четыре вещи, перечисленные самими авторами:
- находит «проблемные портфели», из-за которых MVO ломается: это наименее важные главные компоненты;
- предлагает простую починку, улучшенную оптимизацию EPO, со сжатием корреляций и решением в закрытой форме;
- показывает, что эта починка объединяет ряд известных методов: модель Black–Litterman, робастную оптимизацию, ridge-регрессию из машинного обучения;
- проверяет её на данных: на тренде по глобальным фьючерсам и на отраслевом моментуме в акциях США.
Главный практический вывод: сжатие корреляций нужно подбирать по итоговому Шарпу портфеля, а не по качеству оценки матрицы, и тогда оно получается намного сильнее, чем принято.
1. Почему стандартная оптимизация ломается
Что делает MVO
Инвестор получает сигнал об ожидаемых избыточных доходностях активов и оценку ковариационной матрицы . Оптимальный по средне-дисперсионному критерию портфель (формула 3 работы):
Что это такое. Классическое решение Марковица: доли капитала в каждом активе.
Что означает каждый значок. : вектор долей капитала по активам. («гамма»): несклонность к риску; чем она больше, тем меньше позиции. : обратная ковариационная матрица. : сигнал, у авторов он сразу отмасштабирован так, чтобы равняться ожидаемой избыточной доходности.
Счёт словами. Прогноз доходности делится на риск с учётом связей между активами. Если два актива почти одинаковы, а прогнозы по ним чуть различаются, оптимизатор строит крупную позицию «лонг одного, шорт другого», потому что по его расчёту риск такой пары почти нулевой.
Зачем это нужно. Этот портфель даёт наибольший Шарп, если доходности и риск измерены верно. Авторы сразу добавляют, что он чувствителен к ошибкам измерения.
Проблемные портфели
Чтобы найти, где именно сидит ошибка, авторы переходят к главным компонентам корреляционной матрицы.
Что такое главные компоненты, на пальцах. Это портфели «лонг-шорт», не коррелированные между собой и упорядоченные по дисперсии. Первая компонента самый рискованный портфель, обычно «весь рынок вверх или вниз». Последние компоненты это тонкие комбинации вида «лонг одного актива, шорт почти такого же», им данные приписывают очень малый риск.
Раз компоненты не коррелированы, оптимальная позиция в каждой считается отдельно (формула 5):
Что это такое. Номинальная позиция оптимального портфеля в главной компоненте номер .
Что означает каждый значок. : ожидаемая доходность компоненты. : её дисперсия, её волатильность. Первая дробь это Шарп компоненты, вторая плечо, нужное, чтобы довести её волатильность до единицы.
Счёт словами. Желаемый риск в компоненте пропорционален её Шарпу, а номинал ещё и обратно пропорционален её волатильности.
Зачем это нужно. Отсюда видны две беды последних компонент. Их риск отобран как наименьший, поэтому ошибки оценки скорее его занижают. А шум в оценке доходности у них велик по сравнению с риском, поэтому оценка Шарпа завышена. Оптимизатор хочет большой риск из-за завышенного Шарпа и берёт большое плечо из-за заниженной волатильности. Авторы:
"Further, these two problems exacerbate each other."
На данных это видно на рисунке 1 работы. Он построен по 55 глобальным фьючерсам за 1985–2018 годы, выборка Global 1; номера компонент идут от самой важной (1) к наименее важной (55).
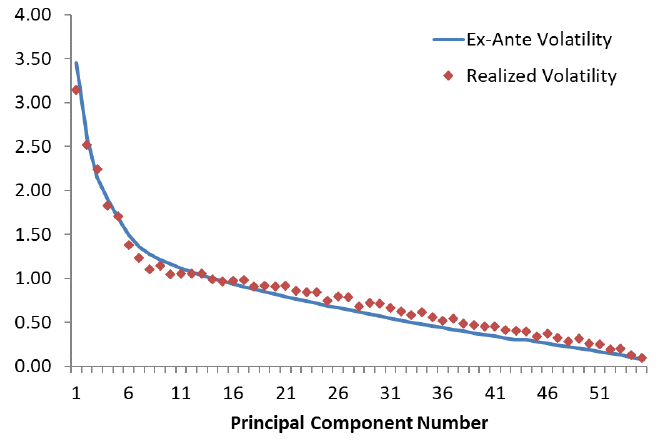
Как его читать. Линия: волатильность компоненты по модели риска. Точки: реализованная.
Что нужно увидеть. В целом модель работает: обе убывают с номером компоненты. Но у последних компонент точки систематически выше линии. Авторы формулируют осторожно: их риски
"tend to be slightly underestimated".
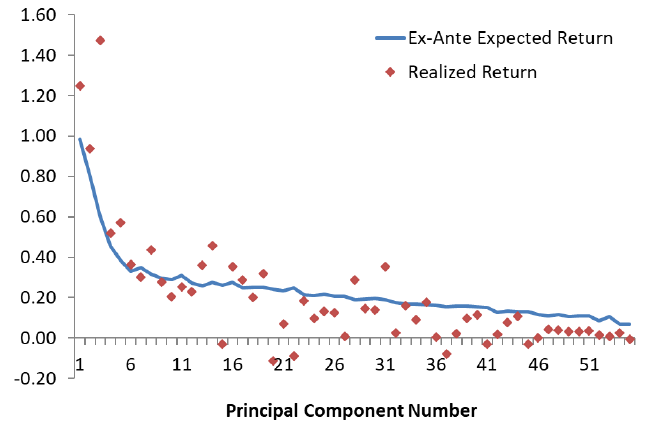
Как его читать. Линия: ожидаемая доходность по сигналу, точки: реализованная.
Что нужно увидеть. Обе в среднем падают с номером компоненты, но реализованная подходит к нулю быстрее ожидаемой. Для последних компонент ожидаемая доходность слишком высока.
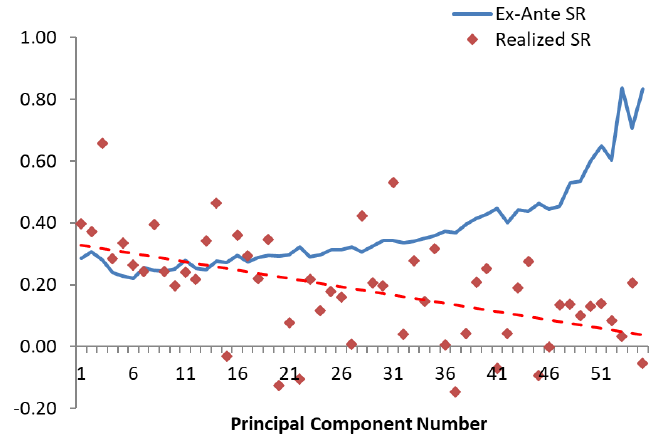
Как его читать. Синяя линия: ожидаемый Шарп, точки: реализованный, красная пунктирная прямая: тренд реализованного.
Что нужно увидеть. Ожидаемый Шарп растёт с номером компоненты, примерно от 0.3 до 0.8, а реализованный падает, по линии тренда примерно от 0.33 почти до нуля. Значения сняты на глаз. Авторы объясняют: первые компоненты скорее отражают настоящие экономические факторы, последние это неинтуитивные «лонг-шорт» факторы с низким отношением сигнала к шуму.
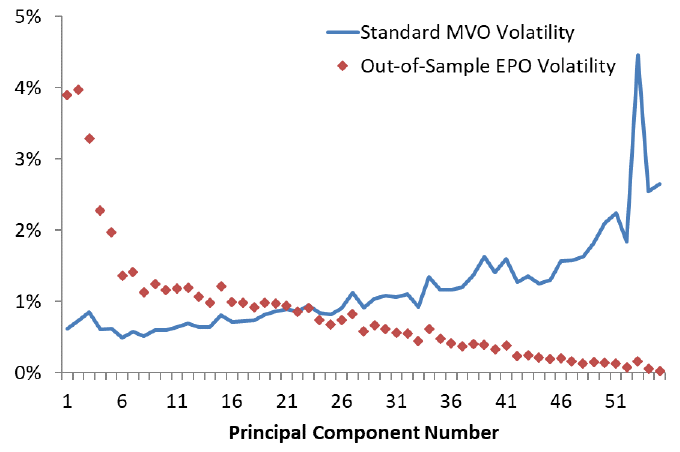
Как его читать. Линия: какой риск стандартная MVO на деле взяла в каждой компоненте; точки: то же для EPO вне выборки. Оба портфеля приведены к 10 % годовой волатильности за весь период.
Что нужно увидеть. MVO берёт больше всего риска в последних компонентах, с пиком около 4.5 % у компоненты в районе 53, а в первых меньше 1 %. EPO наоборот: около 4 % в первых двух и почти ничего в последних. Подпись к рисунку:
"standard MVO invests too heavily in problem portfolios while EPO does not". Номиналы в последних компонентах ещё больше, потому что их приходится брать с плечом; это на рисунке не показано.
2. Метод в одну строку: простой EPO
Раз беда в том, что риск последних компонент занижен, а первых завышен, естественно подтянуть их дисперсии к среднему. Средняя дисперсия компонент корреляционной матрицы равна единице, поэтому (формулы 6 и 7):
Что это такое. Главное наблюдение работы: сжать дисперсии главных компонент к их среднему это ровно то же самое, что сжать корреляционную матрицу к единичной.
Что означает каждый значок. : диагональная матрица дисперсий главных компонент. («омега»): корреляционная матрица активов. : единичная матрица, единицы на диагонали и нули вне её. («тета»): степень сжатия от 0 до 1. Тильда над буквой означает «исправленное».
Счёт словами. Взять корреляционную матрицу, умножить все элементы вне диагонали на , диагональ оставить единицами.
Зачем это нужно. Повышая риск проблемных портфелей, мы снижаем их ожидаемый Шарп, и оптимизатор перестаёт на них грузиться. Сжатие корреляций к нулю делает это напрямую.
Простой EPO собирается так: корреляции между любой парой активов заменяются на , и по изменённой ковариационной матрице запускается обычная MVO. Авторы: "That's it! Note that this is very easy to do." Формально (формулы 15 и 16):
Что это такое. Портфель простого EPO.
Что означает каждый значок. («дубль-вэ»): параметр сжатия EPO от 0 до 1. : оценка ковариационной матрицы, возможно уже слегка исправленная. : диагональная матрица одних дисперсий, без корреляций. : смесь двух, то есть та же матрица с корреляциями, умноженными на .
Что происходит на краях. При это стандартная MVO. При корреляции обнулены, и решение, по словам авторов, по сути совпадает с отказом от оптимизации, похоже на стандартные факторы Фамы–Френча и ещё больше на портфели, взвешенные по силе сигнала. Между ними, как пишут авторы, получается нечто среднее, но
"in a way that works surprisingly well".Пример на числах, наш пример. Корреляция двух активов по данным 0.90, третьего с первым 0.30. При они становятся 0.225 и 0.075. Оптимизатор больше не видит «почти одинаковых» активов и не строит большую ставку на их разнице.
Зачем это нужно. Решение линейно по , поэтому Шарп портфеля от несклонности к риску не зависит: можно взять равным единице или подобрать под нужный уровень риска.
Сначала сжать, потом оптимизировать. В сноске 2 авторы оговаривают, что это не простое усреднение двух готовых портфелей. Если посчитать MVO без сжатия и портфель с полным сжатием и взять их смесь в любой пропорции, получится хуже EPO, особенно когда MVO ведёт себя плохо. Причина, по их словам, в том, что сжатие корреляций стабилизирует сам процесс оптимизации.
Как выбирают . Это эмпирический вопрос. Вне выборки авторы в каждый период находят из конечной сетки значений, которое дало бы лучший Шарп на всей истории до этого момента, и применяют его в следующем периоде. Для первого выбора нужно не меньше 15 лет данных.
3. Почему сжимать так сильно
По словам авторов, в нескольких применениях хорошо работает . При этом для того, чтобы исправить саму корреляционную матрицу, то есть ошибки модели риска, "we typically need to shrink the correlation matrix only about 5% to 10%". Откуда разница почти на порядок?
Ответ авторов: ошибки в оценках ожидаемых доходностей тоже делают сжатие корреляций полезным, и "these errors may be much larger than the errors in the correlation matrix itself". Это показано двумя путями.
Байесовская модель. Инвестор знает, что его сигнал зашумлён: , где настоящая ожидаемая доходность, а шум имеет ковариацию . Его априорное представление о привязано к «якорному» портфелю , типичному для него портфелю или стратегическому распределению. Решение (формула 10) выглядит как MVO, в которой изменены и средние, и ковариации, хотя ошибки допущены только в средних: "errors in expected returns alone lead to the shrinkage of correlations, even when correlations are assumed to be known without error".
Робастная оптимизация. Выбрать портфель, лучший при наихудшей ожидаемой доходности внутри эллипсоида вокруг сигнала. Решение (формула 12) в точности совпадает с байесовским. По словам авторов, эта постановка и её решение новые.
Если считать, что ошибки в сигнале независимы между активами, , общее решение записывается через один параметр (формула 14):
Что это такое. Общий EPO с якорем.
Что означает каждый значок. : якорный портфель. («лямбда»): размер ошибки в оценке ожидаемых доходностей. («тау»): насколько сильно настоящие ожидаемые доходности колеблются во времени.
Счёт словами. Один и тот же параметр одновременно сжимает ожидаемые доходности к якорю и корреляции к нулю. При это MVO, при якорный портфель.
Зачем это нужно. Два трудных параметра и исчезают, остаётся их соотношение. Интуиция авторов: оптимальное больше, когда ошибки измерения больше (плохие данные, неликвидность, слабый предиктор), и меньше, когда настоящие ожидаемые доходности сильнее колеблются.
Если взять якорь , то есть портфель с полным сжатием, общий EPO превращается в простой EPO из раздела 2.
4. Якорный EPO и объединение методов
Якорный EPO. Некоторые инвесторы хотят, чтобы портфель оставался привязан к ориентиру: к индексу, против которого их меряют, или к эвристике вроде «поровну между хорошими акциями». Для этого авторы дают формулу 17, где несклонность к риску выбирается так, чтобы риск части, построенной по сигналу, равнялся риску якоря. Это решает практическую трудность: сигнал часто известен лишь с точностью до масштаба (например, ранжирование по дешевизне), и подставить в формулу «правильные единицы» нельзя.
Объединение. Предложение 3 работы перечисляет, чему равно общее решение EPO в частных случаях:
- стандартной MVO, если ни в оценке риска, ни в сигнале нет шума;
- якорному портфелю при , как в обратной MVO;
- байесовской оценке, равносильной модели Black–Litterman, если якорь это рыночный портфель, сигнал это их «портфели взглядов», а ковариации известны без ошибки;
- решению робастной оптимизации с эллипсоидальным множеством неопределённости;
- обобщённой ridge-регрессии ожидаемых доходностей на ковариационную матрицу.
Объединение не всеобъемлющее, авторы оговаривают это сами: "EPO obviously does not nest all methods". Методы улучшения самой ковариационной матрицы (сжатие Ledoit–Wolf, факторные модели, теория случайных матриц) в этот список не входят. Наоборот, авторы пишут, что EPO заметно их превосходит, потому что сжимает намного сильнее и учитывает шум и в риске, и в доходностях.
5. Данные и постановка
Всего 11 выборок, различающихся активами, моделью риска и сигналом (таблица 1 работы).
Global 1–3. 55 ликвидных фьючерсов и форвардов из работы Moskowitz, Ooi и Pedersen (2012): акции, облигации, товары и девять валютных пар к доллару США. Кросс-курсы исключены, чтобы ковариационная матрица была полного ранга. Данные с 1970 года, бэктест с 1985 по 2018. Модель риска: волатильности по экспоненциально взвешенным дневным доходностям с центром масс 60 дней, корреляции по трёхдневным доходностям с центром масс 150 дней. Global 2 дополнительно сжимает корреляции на 5 %, Global 3 чистит их методами теории случайных матриц.
Equity 1–8. 49 отраслевых портфелей США с сайта Кеннета Френча; в Equity 8 каждая отрасль разбита на две половины по прошлой 12-месячной доходности по данным CRSP, всего 98 активов. Данные с 1927 года, бэктест с 1942 по 2018. Ковариации по окнам 60 месяцев, 40 дней или 120 дней, корреляции сжаты на 5 %. В Equity 6 и 7 используется якорный EPO с якорем 1/N и .
Сигнал. Везде прошлая 12-месячная доходность. Для фьючерсов это тренд (TSMOM):
Что это такое. Ожидаемая месячная избыточная доходность инструмента в месяце .
Что означает каждый значок. : оценка волатильности инструмента. («знак»): , если доходность за прошлые 12 месяцев положительна, иначе . 0.1: месячный Шарп каждого инструмента, принятый постоянным.
Зачем это нужно. Авторы подобрали несклонность к риску так, чтобы EPO с полным сжатием в точности совпадал со стандартным трендом с равным риском из работы 2012 года. Тогда разница между EPO и трендом показывает вклад одних только корреляций. Масштаб 0.1, по их словам, на Шарп итогового портфеля не влияет.
Для отраслей сигнал поперечный: прошлая 12-месячная доходность отрасли минус средняя по всем отраслям, отмасштабированная так, чтобы положительные и отрицательные сигналы в сумме давали по единице (формула 18). В Equity 4 и 5 он дополнительно умножен на или .
6. Результаты на глобальных фьючерсах
Шарпы до издержек, таблица 2 работы (в подписи прямо: "realized gross Sharpe ratios"):
| Портфель | Global 1 | Global 2 (сжатие 5 %) | Global 3 (RMT) |
|---|---|---|---|
| Только лонг, поровну по номиналу (1/N) | 0.44 | 0.44 | 0.44 |
| Только лонг, поровну по риску (1/σ) | 0.76 | 0.76 | 0.76 |
| Тренд, поровну по номиналу | 0.74 | 0.74 | 0.74 |
| Тренд, поровну по риску | 1.09 | 1.09 | 1.09 |
| EPO вне выборки | 1.24 | 1.24 | 1.23 |
| EPO, w = 0 % (обычная MVO) | 0.87 | 1.08 | 1.02 |
| EPO, w = 25 % | 1.24 | 1.26 | 1.26 |
| EPO, w = 50 % | 1.31 | 1.31 | 1.32 |
| EPO, w = 75 % | 1.32 | 1.31 | 1.32 |
| EPO, w = 90 % | 1.26 | 1.26 | 1.26 |
| EPO, w = 100 % (якорь) | 1.09 | 1.09 | 1.09 |
Как читать. Тренд с равным риском уже сильный ориентир: по словам авторов, он делает часть работы оптимизатора, учитывая и ожидаемые доходности, и разницу волатильностей; не использует он только корреляции. Авторы:
"Nevertheless, the out-of-sample EPO significantly outperforms TSMOM by 14%".Что важно. Прирост с 1.09 до 1.24 получен на том же сигнале и тех же инструментах; изменился только способ превратить сигналы в веса. Стандартная MVO (0.87 в Global 1) хуже простого тренда с равным риском. Строки с постоянным посчитаны внутри выборки: выбрать лучшее задним числом в реальном времени нельзя, авторы это оговаривают.
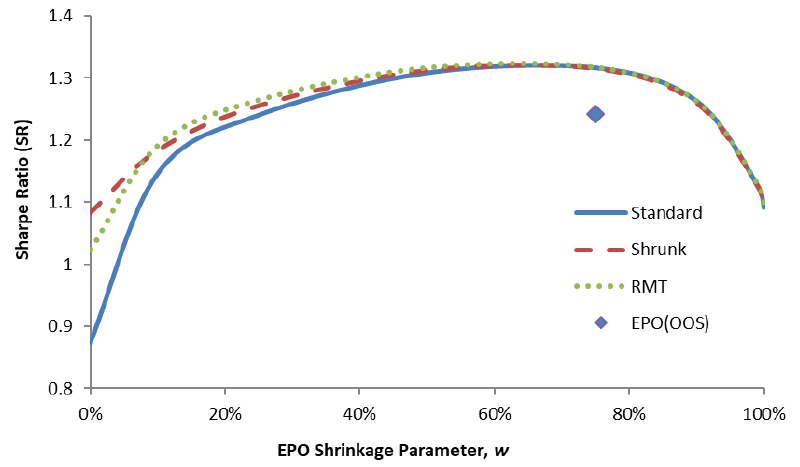
Как его читать. По горизонтали от 0 до 100 %, по вертикали Шарп. Три кривые для трёх моделей риска (стандартная, сжатая на 5 %, очищенная RMT), ромб для EPO вне выборки.
Что нужно увидеть. Слева кривые расходятся: улучшение корреляционной матрицы поднимает Шарп MVO с 0.87 до 1.02–1.08. Около максимума они сливаются. Авторы:
"improving the correlation matrix is important for standard MVO, but has little effect when we subsequently shrink the correlation by a large factor". Кривая пологая в широком диапазоне: по таблице от 25 до 90 % Шарп от 1.24 до 1.32.
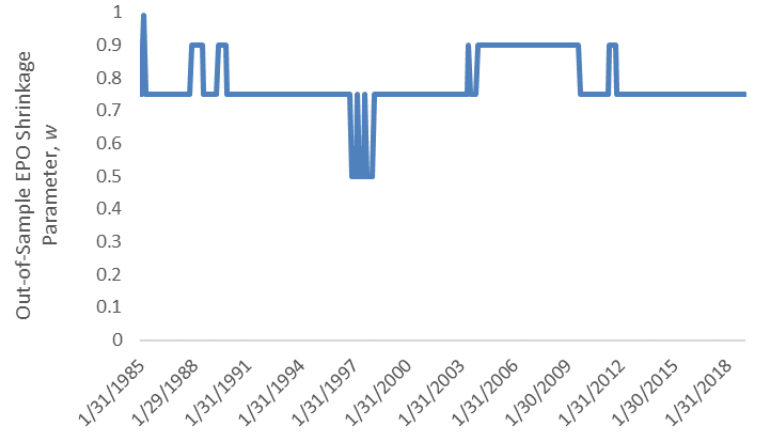
Как его читать. По горизонтали время с 1985 по 2018 год, по вертикали выбранное на каждый месяц .
Что нужно увидеть. Большую часть времени параметр стоит на 0.75, длительный отрезок примерно с 2004 по 2010 год на 0.9, короткие провалы до 0.5 около 1997 года, в самом начале 1. Авторы пишут, что вначале процесс берёт меньшее сжатие и ему нужно время, чтобы прийти к лучшему значению; поэтому EPO вне выборки немного ниже максимума внутри выборки.
Альфа (таблица 3). Все ряды приведены к 10 % годовой волатильности. Регрессия EPO на тренд с равным риском даёт альфу 2.48 % в год (t = 3.36) при 83 % и информационном отношении (information ratio) 0.60. С добавкой длинного портфеля альфа 2.17 % (t = 2.92), с длинным портфелем и трендами по каждому из четырёх классов активов 2.11 % (t = 2.93). Обратная регрессия, тренда на EPO, даёт незначимую альфу −0.43 % (t = −0.57).
Плечо и оборот (таблица 4, Global 2, при 10 % волатильности).
| Портфель | Валовое плечо | Годовой оборот, % от среднего плеча |
|---|---|---|
| Тренд, поровну по риску (якорь, w = 100 %) | 358 % | 163 % |
| EPO вне выборки | 457 % | 254 % |
| EPO, w = 90 % | 424 % | 208 % |
| EPO, w = 75 % | 479 % | 263 % |
| EPO, w = 0 % (обычная MVO) | 991 % | 546 % |
Чем слабее сжатие, тем больше плечо и оборот. Авторы делают вывод, что при подходящем портфели реализуемы, и прямо оговаривают: "While the EPO method shown here abstracts from transaction costs". Учёт издержек внутри оптимизации, по их словам, мог бы снизить оборот; это оставлено для будущих работ.
7. Результаты на отраслях США
Таблица 5 работы, Шарпы до издержек, 1942–2018:
| Портфель | Диапазон по Equity 1–8 |
|---|---|
| 1/N, поровну по номиналу | 0.57–0.59 |
| Стандартный отраслевой моментум (INDMOM) | 0.63–0.67 |
| MVO без сжатия корреляций | от −0.02 до 0.92 |
| EPO вне выборки | 0.66–0.99 |
Как читать. EPO вне выборки обыгрывает 1/N, отраслевой моментум и MVO во всех восьми вариантах. Он близок к лучшему внутри выборки значению с постоянным везде,
"except for Equity 2": там 0.72 вне выборки против 0.93 внутри. MVO без сжатия ведёт себя крайне неустойчиво: от 0.92 в Equity 3 до −0.02 в Equity 2.Сравнение с факторами. По сноске 22, с 1963 по 2018 год пять факторов Фамы–Френча дают Шарпы от 0.27 до 0.49, а их равновзвешенная смесь 0.93. Все варианты EPO вне выборки выше каждого отдельного фактора, а лучшие выше и смеси, хотя EPO опирается только на доходности отраслей.
Альфа (таблица 6). Регрессия EPO вне выборки на отраслевой моментум и пять факторов Фамы–Френча, 1963–2018, всё при 10 % волатильности. Альфа положительна везде, от 1.07 до 8.09 % в год. Значима на уровне 5 % везде, кроме Equity 6, где "the t-statistic of 1.80 is only significant at a 10% level". В Equity 2–4 t-статистика выше 6. Слабость Equity 6 авторы объясняют тем, что якорем там служит длинный портфель 1/N: отсюда нагрузка на рынок 0.85 и конфликт между стабилизацией и сдвигом к портфелю, который не использует сигнал.
8. Что в работе шатко
Оговорки самих авторов
Издержек нет. Все Шарпы валовые, оптимизация издержек не учитывает. При этом EPO вне выборки торгует с бо́льшим плечом и оборотом, чем тренд с равным риском: 457 % против 358 % и 254 % против 163 % в год.
Лучшее внутри выборки недостижимо. Строки таблиц с постоянным это знание задним числом. Честное сравнение только со строкой «вне выборки», и на фьючерсах она на 0.07–0.09 ниже максимума внутри выборки (наш расчёт по таблице 2).
Конфликт интересов раскрыт. В первой сноске: AQR "may or may not apply similar investment techniques or methods of analysis as described herein". Тренд, на котором проверяется метод, построен по работе, где один из авторов соавтор.
Сигнал простой намеренно. Везде прошлая 12-месячная доходность. Авторы пишут, что метод общий, и оставляют другие предикторы будущим исследованиям.
Объединение не всеобъемлющее. EPO не включает все методы, это сказано прямо.
Что видно при чтении, но в работе не обсуждается
Расхождений, подтверждённых цитатой, в нашем рабочем разборе нет, поэтому discrepancies равно нулю. Числа мы не пересчитывали.
Данные для главного результата закрытые. Ряды по 55 фьючерсам собраны авторами и не опубликованы; Equity 8 опирается на лицензируемую базу CRSP. Отраслевые портфели Equity 1–7 и факторы Фамы–Френча открыты, и эту часть можно повторить.
Выбор сам является подгонкой, хоть и честной. Сетка значений конечна, отбор по прошлому Шарпу. На рисунке 2 параметр почти всё время стоит на одном из трёх значений (0.5, 0.75, 0.9). Насколько итог чувствителен к шагу сетки, в работе не показано.
Только моментум. Обе проверки на моментум-сигналах, где сигнал прямо связан с прошлыми доходностями. Для сигналов с другой структурой ошибок величина лучшего сжатия может быть другой; по логике самой работы она зависит от соотношения шума в сигнале и колебаний настоящих доходностей.
9. Что из этого следует на практике
Проблема оптимизации не в оптимизации, а в доверии к тонким комбинациям. Выбор не между «оптимизировать» и «1/N», а в том, насколько верить последним главным компонентам.
Починка стоит одной строки. Умножить внедиагональные элементы корреляционной матрицы на и запустить ту же оптимизацию. Библиотеки и сложные вычисления для этого не нужны.
Подбирать сжатие по итоговому Шарпу вне выборки, а не по качеству оценки матрицы. Это два разных критерия, и у авторов они дают ответы около 75 % и около 5–10 %.
Около оптимума результат нечувствителен к . На фьючерсах Шарп от 1.24 до 1.32 при от 25 до 90 %. Это значит, что сам параметр не становится новым источником подгонки, но и что точное значение искать не обязательно.
Сначала сжать, потом оптимизировать. Смесь готового портфеля MVO и портфеля без корреляций, по сноске авторов, работает хуже при любой пропорции.
Плечо и оборот считать рядом с Шарпом. Меньшее сжатие быстро наращивает и то и другое: у MVO без сжатия плечо 991 % и оборот 546 % против 358 % и 163 % у якоря, то есть примерно в 2.8 и 3.3 раза больше (наш расчёт по таблице 4). Выигрыш в валовом Шарпе нужно сравнивать с ценой этого оборота.
Якорь как механизм осторожности. Якорный EPO делает оптимизацию поправкой к понятному портфелю (1/N, равный риск, индекс), а не заменой его.
10. Тестируемые идеи
| № | Идея | Тип | Где считать |
|---|---|---|---|
| 1 | Перед оптимизацией весов умножать внедиагональные корреляции на ; выбирать вне выборки по прошлому Шарпу на расширяющемся окне из сетки значений | изменение конструкции | Python |
| 2 | Строить кривую «Шарп против » от 0 до 1: есть ли внутренний максимум и насколько она пологая около него | диагностика | Python |
| 3 | Разложить свой набор активов или стратегий на главные компоненты и сравнить ожидаемые и реализованные волатильность, доходность и Шарп по номеру компоненты, как на рисунке 1 | диагностика | Python |
| 4 | Сравнить степень сжатия, подобранную по качеству оценки ковариационной матрицы, со степенью, подобранной по Шарпу портфеля вне выборки | аудит | Python |
| 5 | Отчитывать валовое плечо и годовой оборот рядом с Шарпом для каждого и считать Шарп после своих издержек | метрика приёмки | бэктестер |
| 6 | Якорный EPO с текущими эвристическими весами (поровну по номиналу или по риску) в роли якоря: смотреть, какие поправки предлагает оптимизация | изменение конструкции | Python |
| 7 | На неизменных сигналах разложить прирост по ступеням: поровну по номиналу, поровну по риску, EPO вне выборки | диагностика | бэктестер |
| 8 | Проверить на своих данных сноску 2: сравнить EPO со смесью готовых портфелей MVO и с полным сжатием в разных пропорциях | аудит | Python |