Как читать этот разбор. Главный вывод работы умещается в одну фразу: менять веса сигналов по режиму имеет смысл, когда сигналы плохо диверсифицируют друг друга, а не когда режим хорошо распознаётся. Это раздел «Главный тезис» и раздел 4. Разделы 1–3 показывают, откуда вывод берётся: формулы разобраны по значкам, но их можно пропустить. Числа в примерах, помеченных «наш пример», взяты из нашего рабочего разбора; числа работы мы не пересчитывали.
Главный тезис
Стратегию можно собрать из нескольких сигналов, скажем из value (дешевизна) и momentum (сила прошлого роста). Есть два способа их смешать:
- статический: веса заданы раз и навсегда;
- динамический: веса зависят от рыночного или экономического режима. Автор отмечает, что это то же, что factor timing или style rotation.
Интуиция подсказывает: если мы умеем распознать режим и знаем, что в режиме A лучше работает momentum, а в режиме B value, динамический подход должен выигрывать. Автор показывает, что этого мало. В аннотации: "But interestingly, this is not a sufficient condition." Нужны два условия сразу:
- поведение сигналов действительно различается от режима к режиму;
- доходности сигналов сильно коррелированы между собой.
Второе условие неочевидно. Логика автора такая: если сигналы слабо или отрицательно коррелированы, статическая смесь уже хорошо диверсифицирована, и её качество держится на диверсификации, а не на угадывании режима. Сдвигая веса, мы теряем диверсификацию. Вывод в заключении сформулирован осторожно: "Usually, the more diversified the static model, the lower the gain in contextual modeling." И дальше: "the results suggest that the first-best solution is to build well diversified strategies". Если это невозможно, контекстное моделирование, по словам автора, может стать ценной альтернативой, но "this alternative is risky".
Работа намеренно упрощает картину, автор пишет об этом прямо: "This is why we simplify reality." Два сигнала, портфели без ограничений, постоянная корреляция, точно известный режим. Цель в том, чтобы условия, при которых динамика полезна, были видны в самом прозрачном виде.
1. Как устроена модель
Прогноз как смесь сигналов
Что это такое. Начало любой многофакторной модели: прогноз доходности собирается как взвешенная сумма сигналов.
Что означает каждый значок.
- («альфа»): столбик из чисел, по одному на каждый актив вселенной. Это наш прогноз доходности по каждому активу.
- («зет один», «зет два»): тоже столбики из чисел, значения первого и второго сигнала по каждому активу. Например, показывает, насколько акция дешёвая, насколько она выросла за год.
- («дубль-вэ»): веса сигналов, два обычных числа. Их мы и выбираем.
Счёт по шагам, наш пример. Три акции. Сигнал дешевизны , сигнал моментума , веса и . Первая акция: . Вторая: . Третья: . Первую покупаем сильнее всего, третью продаём.
Зачем это нужно. Веса и есть предмет спора между статическим и динамическим подходом. Автор оговаривает в сноске, что веса не обязаны давать в сумме единицу: их общий размер задаёт целевая волатильность стратегии.
Что это такое. Переход от сигнала к портфелю: из оценок по активам получаются конкретные позиции.
Что означает каждый значок.
- («сигма» заглавная): ковариационная матрица доходностей активов, таблица . На диагонали дисперсии отдельных активов, вне её совместные колебания пар.
- : обратная матрица. Для обычного числа обратное к 5 это 1/5; для матрицы смысл тот же, только «единицей» служит матрица с единицами на диагонали.
- : позиции портфеля, построенного по сигналу номер .
Счёт словами. Умножение на похоже на деление прогноза на риск, только с учётом связей между активами. Волатильный актив получает меньшую позицию. Из двух очень похожих активов не берутся две полные позиции, потому что это была бы одна ставка двойного размера.
Зачем это нужно. Дальше автор работает не с сигналами, а с этими «сигнальными портфелями»: доходность стратегии оказывается взвешенной суммой их доходностей.
Сигналы нормируются так, чтобы каждый сигнальный портфель имел единичную волатильность: . Тогда ожидаемая доходность всей стратегии записывается совсем просто:
Что это такое. Ожидаемая доходность стратегии из двух сигналов.
Что означает каждый значок. (information ratio, «ай-ар»): ожидаемая доходность сигнального портфеля, делённая на его волатильность. По смыслу это тот же коэффициент Шарпа, только для портфеля «лонг-шорт» без рыночной части. Раз волатильность каждого сигнального портфеля равна единице, его вклад в доходность равен его , умноженному на вес.
Зачем это нужно. Задача «как смешать сигналы» сводится к задаче «как разделить риск между двумя ставками с известным качеством».
Оптимальные веса
Целевой риск стратегии автор без потери общности приравнивает единице и ищет веса, дающие наибольшую доходность:
Что это такое. «Максимизировать доходность при фиксированном риске». Значок с подписью читается как «выбрать те и , при которых выражение наибольшее».
Что означает условие. Левая часть это квадрат волатильности смеси двух сигнальных портфелей. («ро»): корреляция их доходностей. Автор оговаривает:
"For the sake of simplicity, this correlation is assumed to be constant over time."Почему перекрёстный член важен. При риски двух ставок складываются «по Пифагору», общий риск меньше суммы. При сигналы дублируют друг друга, и диверсификации нет. При ставки гасят друг друга.
Что это такое. Решение задачи, формула (5) работы.
Что означает каждый значок. («лямбда»): множитель Лагранжа, технический коэффициент, который подгоняет общий размер весов под заданный риск. Звёздочка означает «оптимальное значение».
Счёт словами. В числителе вес сигнала равен его собственному качеству минус качество соседа, умноженное на корреляцию. Сигнал наказывается за то, что повторяет соседа.
Пример на числах, наш пример. , . При числители равны 0.6 и 0.4: веса пропорциональны качеству. При числители и : второй сигнал получает отрицательный вес и нужен только как хедж к первому.
Зачем это нужно. Отсюда видно, когда второй сигнал как самостоятельная ставка лишний: когда .
Что это такое. Качество оптимальной смеси, формула (6). Множитель Лагранжа оказывается равен лучшему достижимому .
Пример на числах, наш пример. , . При : , лучше каждого сигнала по отдельности. При : . При : , почти ничего сверх лучшего сигнала.
Зачем это нужно. Ценность второго сигнала определяется не только его качеством, но и тем, насколько он непохож на первый.
2. Статика против динамики: насколько расходятся веса
Автор вводит режимов («контекстов») с номером . Это может быть рыночный, экономический или любой другой контекст. Сравнивать предлагается два отношения:
Что это такое. : во сколько раз второй сигнал лучше первого в среднем по всей истории. : то же внутри режима .
Допущение автора. Ожидаемые обоих сигналов всегда строго положительны, поэтому и тоже положительны. В сноске уточнено, откуда берутся эти числа на практике: например, как исторические средние по всей истории и по периодам режима .
Ключевая мысль, которую автор выделяет отдельно. Значение имеет относительное качество сигналов, а не абсолютное. Если в кризис оба сигнала стали вдвое хуже, то , и менять веса незачем. Автор подчёркивает, что это особенно важно для стратегий с постоянной целевой волатильностью.
Статический подход держит оптимальные веса постоянными. Динамический в каждом режиме берёт веса, оптимальные для этого режима; автор оговаривает в сноске, что текущий режим считается известным, однозначно определённым и не меняющимся на горизонте инвестирования: "supposing that this context does not change on the investment horizon considered".
Разница весов и (динамический минус статический) выписана в формуле (7) работы; она зависит только от , и . Расстояние между двумя моделями автор меряет так:
Что это такое. Насколько веса динамической модели в режиме отличаются от статических. Автор называет это среднеквадратичной разницей весов и ссылается на Sorensen и соавторов (2005).
Что означает каждый значок. («дельта»): разница. : вес первого сигнала в режиме минус его постоянный вес.
Зачем это нужно. Это промежуточный измеритель. Если расстояние мало, две модели почти совпадают, и спорить не о чем.
Что доказывает автор. По расстояние имеет форму буквы U с нулём в точке : чем сильнее режим меняет относительное качество сигналов, тем сильнее расходятся модели. По поведение зависит от случая. Если в режиме меняется лидер (в среднем лучше один сигнал, а в режиме другой, то есть или ), расстояние монотонно растёт с ростом корреляции. Иначе оно имеет форму перевёрнутой U с максимумом при положительной корреляции.
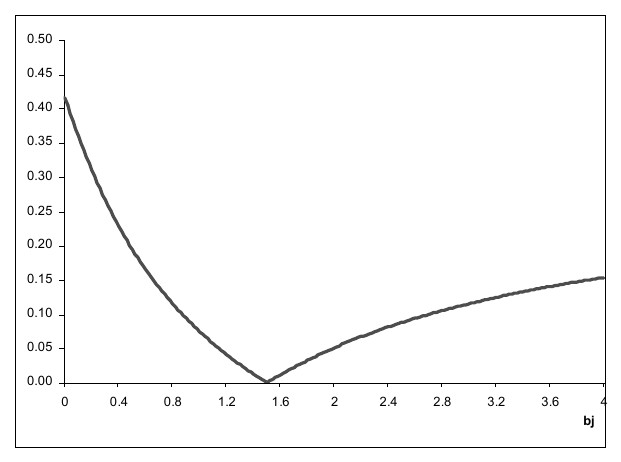
Как его читать. По горизонтали от 0 до 4, по вертикали расстояние . Посчитано по формуле работы при и ; по словам автора, такое значение корреляции
"is roughly in line with the level of valuation and momentum performance correlation found in equity universes".Что нужно увидеть. Кривая касается нуля ровно при , там, где режим ничем не отличается от среднего. Влево она поднимается круче: на глаз около 0.42 при против примерно 0.15 при .
Почему корреляция так сильно влияет на результат, видно из отношения весов:
Что это такое. Отношение оптимальных весов, формула (9): слева статическое, справа в режиме .
Счёт по шагам. Подставим : получится , и то же для . То есть при корреляции, стремящейся к , оптимальные веса стремятся стать равными, как бы ни отличалось качество сигналов.
Почему так. Когда две ставки гасят риск друг друга, каждая ценна прежде всего как страховка для другой. Автор пишет, что в этом случае заметное изменение весов вредит стратегии, потому что риск растёт сильнее, чем выигрыш. Поэтому и расстояние между моделями мало.
Зачем это нужно. Автор называет этот результат центральным для объяснения того, когда динамика добавляет ценность.
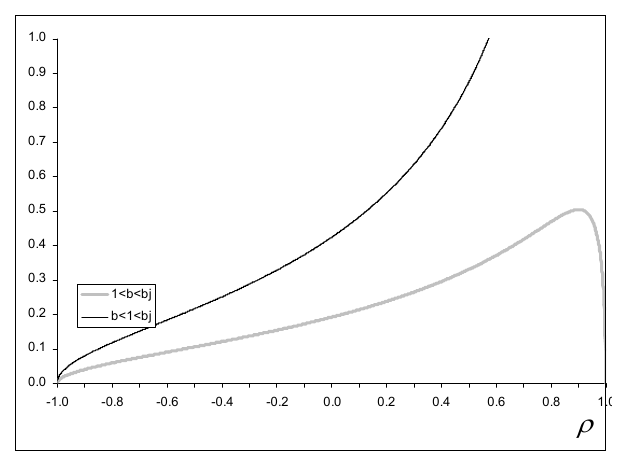
Как его читать. По горизонтали корреляция от до , по вертикали расстояние. Чёрная кривая подписана
b<1<bj(лидер меняется), серая1<b<bj(лидер тот же).Что нужно увидеть. У левого края обе кривые прижаты к нулю: при сильно отрицательной корреляции модели почти неразличимы. Чёрная кривая растёт монотонно и уходит за верх графика. Серая доходит до максимума около 0.5 при высокой корреляции и затем падает. В тексте сказано, что при и максимум достигается при ; в примечании под самим рисунком указано (см. раздел 5).
3. Главный результат: сколько теряет статика
Ожидаемое качество стратегии в режиме при динамических весах (формула 10 работы):
и при статических весах (формула 12):
Что это такое. Буква означает dynamic, static. Обе формулы получены подстановкой оптимальных весов в выражение для . Считать их вручную не нужно: важно их отношение.
Что это такое. Главная формула работы, формула (13): какую долю ожидаемого качества динамической модели сохраняет статическая в режиме .
Что означает каждый значок. от «loss»: относительное качество статики. , , те же, что выше. в отношении сокращается, поэтому от абсолютного качества сигналов не зависит.
Счёт словами. Взять три числа: среднее отношение качества сигналов, то же в режиме и корреляцию. Посчитать числитель, два множителя в знаменателе, извлечь корень, поделить. значит, что динамика ничего не даёт; значит, что статика теряет 10 % качества.
Пример на числах работы. Рисунки 3 и 4 ниже построены именно по этой формуле при , и при или , .
Что доказано про эту величину.
- не больше единицы:
"the ex ante -i.e. based on expectations- value added of the dynamic approach is always positive". В сноске сразу оговорка:"This is not necessarily the case ex post."- зависит только от трёх чисел , , .
- По функция растёт до и убывает после: чем дальше режим уводит относительное качество от среднего, тем больше теряет статика.
- По : если в режиме меняется лидер, монотонно убывает с ростом корреляции, польза динамики растёт. Иначе форма U, и наибольшая польза достигается при положительной корреляции.
Зачем это нужно. Это готовый калькулятор для решения «строить режимный слой или нет»: три числа, и формула говорит, сколько ожидаемого качества мы теряем, оставаясь при постоянных весах. Но только ожидаемого и только при точно известном режиме.
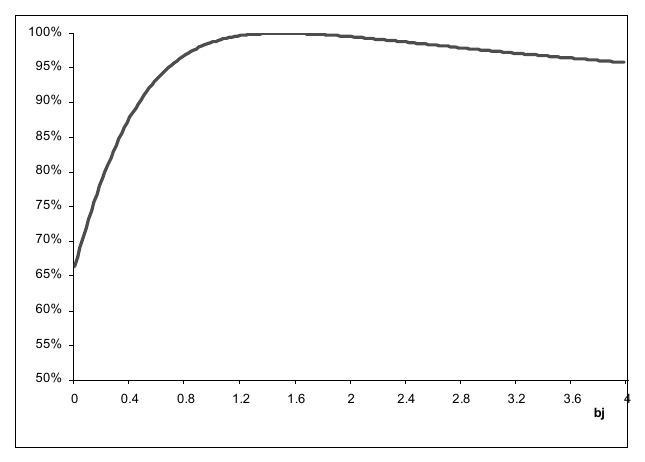
Как его читать. По горизонтали , по вертикали в процентах. Посчитано по формуле (13) при , .
Что нужно увидеть. Кривая около 100 % в районе от 1.2 до 1.8 и опускается в обе стороны, но несимметрично. На глаз: около 66 % при и около 96 % при . Значит, даже при отрицательной корреляции статика может терять заметную долю качества, если режим сильно меняет соотношение сигналов в одну сторону.
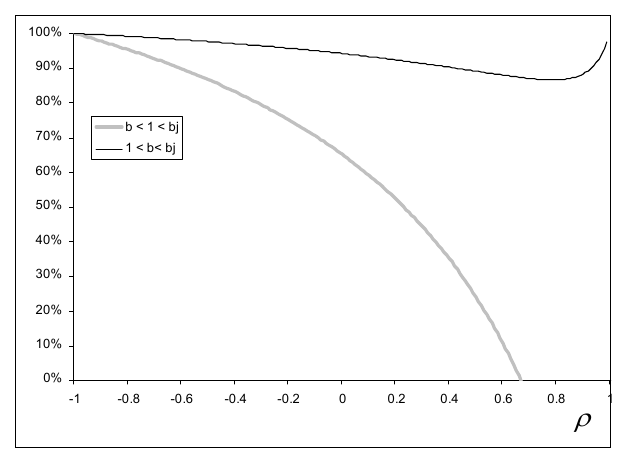
Как его читать. По горизонтали корреляция, по вертикали . Серая кривая
b < 1 < bj(лидер меняется, , ), чёрная1 < b< bj(лидер тот же, , ).Что нужно увидеть. У левого края обе кривые у 100 %: при корреляции около статика не теряет ничего. Чёрная кривая почти горизонтальна и опускается примерно до 87 % при корреляции около 0.8, затем возвращается вверх. Серая падает всё время: около 65 % при нулевой корреляции и до нуля около . Значения сняты на глаз.
Практический вывод. Выигрыш от динамики растёт с корреляцией, а при смене лидера в режиме он может быть большим уже при умеренных корреляциях.
Наконец автор ищет корреляцию, при которой динамика полезнее всего:
Что это такое. Значок читается «то значение аргумента, при котором функция наименьшая». Наименьшее значит наибольшую пользу динамики. Шляпка над («ро с крышкой») означает найденное значение.
Ответ автора. Для разумных значений, когда и не одновременно очень велики или очень малы, эта корреляция довольно высока, а при смене лидера равна 1. В среднем по всем парам и от 0 до 10 с шагом 0.1 (кроме , где при любой корреляции) получилось
"around 0.57, which is indeed relatively strong".Зачем это нужно. Это не порог, после которого динамика окупается, а среднее положение максимума пользы. Оно говорит, что динамическое взвешивание по своему устройству рассчитано на сигналы, которые плохо диверсифицируют друг друга.
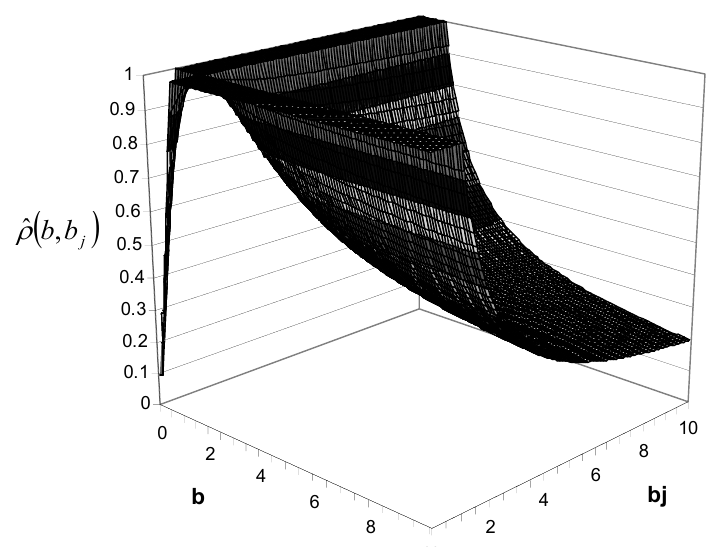
Как его читать. Две горизонтальные оси и от 0 до 10, по вертикали от 0 до 1.
Что нужно увидеть. Вдоль краёв, где лидер меняется, поверхность стоит на уровне 1. Вниз она уходит в углу, где оба отношения велики, и у самого края, где оба малы. На большей части области значения высокие.
4. Два условия автора
В разделе о практических следствиях автор формулирует два условия, при которых польза динамики значима.
Условие 1: режим должен действительно разделять относительное качество сигналов, то есть заметно отличается от . Отсюда выбор индикатора режима: оценивать его надо по способности разводить качество сигналов друг относительно друга, а не по способности объяснять рынок вообще. Автор добавляет, что это условие "necessary but not sufficient".
Условие 2: корреляция доходностей сигналов должна быть высокой. Общее правило автора: чем хуже диверсифицирована статическая модель, тем больше выигрыш динамики. При высокой корреляции выгода от диверсификации мала, и качество стратегии в основном определяется умением поставить на правильный стиль в правильное время. При слабой или отрицательной корреляции ожидаемое качество динамики, по словам автора, "only slightly higher than that of the static model". И итоговая формулировка раздела: "if the static model is already well diversified, the contextual modeling is likely to add little value".
5. Что в работе шатко
Оговорки самого автора
Ожидаемая польза не равна фактической. В заключении перечислено, от чего зависит фактический результат помимо двух условий: неопределённость в определении режима, неопределённость в оценке относительного качества сигналов по режимам и дополнительные издержки от оборота, который создаёт переключение моделей. Автор заканчивает: "The analysis of these effects warrants further research." В самой работе ничего из этого не посчитано.
Режим известен точно и не меняется на горизонте. Это сказано в сноске 3: динамический подход здесь берёт текущий контекст как данность и опирается на допущение, что его можно однозначно охарактеризовать.
Корреляция постоянна. Дано как упрощение. При этом сама работа о том, что параметры сигналов меняются от режима к режиму; постоянство корреляции между режимами проверять приходится отдельно.
Ожидаемые обоих сигналов строго положительны. Это упрощает изложение; случай, когда один из сигналов в режиме в среднем убыточен, не разобран.
Только два сигнала и портфели без ограничений. Обобщение на большее число сигналов в работе не рассматривается.
Что заметили при чтении
Расхождений, подтверждённых цитатой, в нашем рабочем разборе нет, поэтому discrepancies равно нулю. Числа мы не пересчитывали. При чтении PDF бросились в глаза три вещи; они на вывод не влияют и в счётчик не входят.
Подпись к рисунку 2 расходится с текстом. В тексте кривые рисунка 2 описаны при , и , с максимумом "for ρ = 0.94". В примечании под рисунком для обоих случаев указано , и под рисунком 4 тоже . Какое значение верно для рисунка 2, по тексту установить нельзя.
Опечатка в знаменателе формулы (11). Там дважды стоит вместо ; в следующей строке автор использует правильное выражение для волатильности, так что это опечатка набора.
Общая формулировка сильнее рисунков. Фраза о том, что при слабой или отрицательной корреляции динамика лишь немного лучше статики, верна около . Рисунки 3 и 4 той же работы показывают, что при и сильном сдвиге относительного качества статика сохраняет на глаз около двух третей качества динамики. Это наше прочтение рисунков, а не пересчёт.
6. Что из этого следует на практике
До того как строить режимный переключатель, посчитать корреляцию доходностей сигнальных портфелей. Это одно число, которое отвечает на вопрос, есть ли вообще что выигрывать. При сильно отрицательной корреляции оптимальные веса почти не зависят от режима.
Оценить ожидаемую потерю статики по формуле (13). Три числа: среднее отношение качества сигналов, то же в предполагаемом режиме и корреляция. Если потеря мала, режимный слой не окупит ни своих ошибок, ни своего оборота.
Индикатор режима оценивать по тому, разводит ли он сигналы друг относительно друга. Режим, в котором «всё работает хуже», для переключения весов бесполезен: относительное качество не изменилось. При постоянной целевой волатильности общее ухудшение и так снизит вклад стратегии целиком.
Отрицательный оптимальный вес это сигнал о роли, а не о качестве. Если , второй сигнал в оптимальной смеси нужен как хедж, а не как самостоятельная ставка. Отключать его за низкий собственный Шарп в этом случае значит убирать страховку.
Помнить, что польза доказана только в ожидании. Ошибки в определении режима, в оценке и издержки переключения работают против динамики, и автор прямо пишет, что фактическая польза может оказаться отрицательной.
7. Тестируемые идеи
| № | Идея | Тип | Где считать |
|---|---|---|---|
| 1 | До разработки режимного слоя оценить , и корреляцию сигнальных портфелей по истории и посчитать ожидаемую потерю статики по формуле (13) | диагностика | Python |
| 2 | Проверять кандидата в индикаторы режима по тому, насколько в его режимах отличается от , а не по абсолютным метрикам стратегий в этих режимах | аудит | Python |
| 3 | Для каждой пары сигналов считать : при отрицательном значении сигнал нужен как хедж, и критерий его отключения должен быть другим | диагностика | Python |
| 4 | Отдельно мерить оборот, который добавляет само переключение весов при неизменных сигналах, и вычитать его издержки из ожидаемого выигрыша | метрика приёмки | бэктестер |
| 5 | Считать скользящую корреляцию доходностей сигналов по режимам: работа задаёт её постоянной, и если она сама зависит от режима, формула (13) неприменима как есть | аудит | Python |
| 6 | Сравнивать динамическую и статическую смесь вне выборки с режимом, определённым по данным на момент решения: ожидаемая польза неотрицательна, фактическая нет | метрика приёмки | бэктестер |
| 7 | В стратегии с постоянной целевой волатильностью не менять веса сигналов, когда все сигналы ослабли одинаково () | изменение конструкции | любая |